IA en la práctica— 3.ª edición
¡Bienvenidos! Este material nació digital a propósito: al igual que las noticias y los descubrimientos del campo, puede ser revisado y actualizado casi a la misma velocidad — algo imposible en un libro impreso.
El objetivo no es agotar el tema, sino servir deguía de referencia práctica: un lugar del que usted extrae una información específica, copia un prompt y lo adapta a su necesidad. No hace falta leer en orden — vaya directo a lo que necesita.
Cómo navegar: use el índice a la izquierda (en el celular, el botón en la parte superior). Al final de cada capítulo hay los botones ‹ anterior y siguiente ›. ¿Dudas? Los canales de contacto están en el capítulo 15.
Empieza aquí
Escribir prompts
Herramientas de IA
Referencia
Funcionamiento básico de las herramientas de IA
Manteniendo las definiciones teóricas al mínimo necesario: entender cómo funcionan las herramientas de IA es fundamental para extraer sus mejores resultados. Es solo por esa razón que tiene sentido comprender lo básico sobre los fundamentos de estas herramientas — y no será muy complicado. Como probablemente ya haya oído, ChatGPT (y similares) funciona como si fuera un gran predictor de texto. Estamos más o menos acostumbrados a estos recursos en algunas aplicaciones cotidianas. Por ejemplo, en el celular, cuando respondemos nuestros correos, mal empezamos el mensaje y ya aparece una sugerencia de texto subsiguiente (Figura 01).
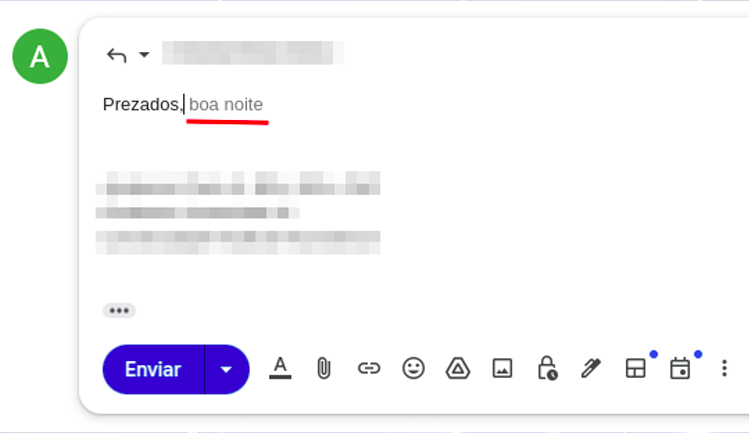
Ese autocompletar existe por una cuestión de "contexto" y por la probabilidad de las palabras en la secuencia. Si le pido completar la frase "el cielo es [___]", ¿qué palabra vino a su mente? La probabilidad de que haya pensado en "azul" o "grande" es mucho mayor que la de haber pensado en "carmesí". Las frases "El cielo es azul", "El cielo es grande" y "El cielo es carmesí" están todas técnicamente correctas, pero no se usan con la misma frecuencia en nuestro cotidiano.
¿Cómo aplicamos esto a las herramientas de IA? Fueron presentadas ("entrenadas") analizando miles de millones — literalmente — de textos y materiales, de forma que poseen datos sobre las probabilidades de ocurrencia de palabras secuenciales. Obviamente es mucho más complejo que esto, pero esta analogía nos ayudará a usar las herramientas de IA de manera más efectiva.
En el contexto de este e-book: treinamento, de manera bien simple, es el nombre dado al proceso de presentación de fuentes de material (por ejemplo, textos en diferentes idiomas) a las IAs, para que sea posible el reconocimiento de patrones y, a partir de ahí, la decisión sobre qué texto o palabra debe venir en la secuencia.
Modelos de IA
Cuando usted abra las herramientas de IA (como Gemini y ChatGPT), acabará encontrando la posibilidad de elegir IAs "diferentes" — lo que llamamos modelos. Entiéndalos como "versiones" de las IAs, de la misma forma que tenemos bicicletas (sin marchas, con 18 marchas, suspensión, fibra de carbono...) o carros (Onix LT, LTZ, Premier...): es más o menos la misma lógica. No hay modelos "correctos o incorrectos": hay modelos más adecuados para cada tarea, con capacidades y precios (o límites de uso) diferentes.
Aquí entran dos categorías importantes: los modelos llamados de razonamiento (thinking models) y los modelos "comunes". En teoría, los modelos de razonamiento son más adecuados para tareas complejas, que envuelven la consideración de múltiples factores. Son más capaces en términos de procesamiento, pero también más lentos para generar las respuestas.
En la práctica, no se preocupe mucho por esto: actualmente (2026) prácticamente todos los modelos relevantes son de razonamiento por defecto, y lo que cambia es cuánto "piensan" antes de responder — muchas herramientas ya ofrecen un selector de intensidad de razonamiento (algo como "rápido" versus "pensar más"), en vez de dos productos totalmente separados. Para tareas simples (resumir, traducir, formatear), prefiera la opción más rápida; para análisis que exijan cruzar varias informaciones, vale la pena activar el razonamiento extendido y esperar un poco más. La idea sigue siendo la misma: probar, sin miedo, los productos y modelos disponibles y verificar cuáles dan las mejores respuestas para cada tarea.
Herramientas principales
Una pregunta frecuente que recibo es: "¿cuál es la mejor herramienta?" La mejor respuesta siempre será "depende", pero voy a elaborar. ¿Qué es mejor: un martillo, un destornillador o un alicate? Depende de lo que usted necesite hacer.
Con los asistentes de IA, la lógica es semejante. GPT, Gemini y Claude son los más conocidos. El GPT tiene el mejor Deep Research disponible (modo de búsqueda/investigación avanzada — será explicado más adelante). El Gemini se integra al ecosistema Google y mejoró considerablemente desde su creación. El Claude, por su parte, tiene excelentes resultados para producción de texto y para tareas que envuelven programación.
Si está pensando en pagar por un asistente de IA, siga estos pasos:
- Pruebe las versiones gratuitas de los servicios que considera contratar durante al menos uno o dos meses.
- No suscriba los llamados "agregadores de IA" (sitios que ofrecen acceso a varios modelos por precios bajos/promocionales): lo más probable es que no atiendan sus necesidades adecuadamente. Con los planes más accesibles de Gemini y ChatGPT disponibles, no vale la pena usar intermediarios.
- Usted puede usar los modelos de Google, gratuitamente, en https://ai.dev.
A continuación se listan las principales herramientas de IA disponibles, gratuitas o pagas.
Uso de las herramientas: la pregunta, el input o el prompt
Empecemos por el prompt. Este es un concepto fundamental: prompt es el nombre dado a las instrucciones que pasamos a las herramientas de inteligencia artificial.
Aspectos fundamentales del prompt
Entendamos el prompt de manera muy directa: imagine que está merendando y un amigo le dice “pásame la manga”. Si está comiendo fruta, la frase apunta a una cosa; si es sastre, apunta a otra completamente distinta. Si el contexto cambia, la misma palabra deja de significar lo mismo. Con la IA ocurre algo muy parecido: sin contexto, el modelo puede interpretar su instrucción de la manera equivocada.
El contexto es importante. En un prompt, es importantísimo.Los prompts eficientes son prompts específicos.
Prompts más eficientes son específicos y proporcionan contextos.
Esto nos trae otro concepto importante: es más útil pensar en prompts "eficientes" o "ineficientes" que en "correctos o incorrectos": lo que vuelve nuestros prompts más eficientes es nuestra habilidad (derivada de la práctica) en adecuar el prompt que escribimos a la tarea que necesitamos hacer. No deja de ser un ejercicio de comunicación como muchos otros que tenemos que hacer en nuestro cotidiano.
Ejemplos de prompts:
1) Prompt directo
"Traduce la letra de la canción de abajo al portugués de Brasil" => es un ejemplo de prompt directo, válido y que puede ser muy útil o no — dependiendo de lo que usted necesite.
Comando: traduzca, transcriba, analice, revise, produzca, organice (...)
Objeto: la letra de música, el texto, el documento, el pdf, el archivo, la imagen (...)
Parámetro de salida: al portugués, para un congreso, para una presentación (...)
2) Prompt con contexto
Aquí añadimos contexto al prompt ("será enviado como resumen de un trabajo de un congreso (...)"). ¿Por qué es importante? Porque enviar un texto a un congreso profesional es bien diferente de escribir un texto para una red social, por ejemplo.
"El texto de abajo será enviado como resumen de un trabajo de un congreso del curso de [psicología/ingeniería/derecho/medicina]. Revise la gramática, la coherencia y la cohesión del texto, sugiriendo alteraciones cuando sea necesario."3) Prompt para el día a día
Otro ejemplo: las IAs pueden servir para cuestiones cotidianas. Un amigo las usa para cocinar: desde las recetas hasta elegir las mejores frutas en el mercado. Explore la versatilidad de las IAs — use el prompt de abajo para eso. En tanto: ¿no sabe qué es un DR? ¡Modifique el prompt de arriba y use alguna de las IAs para aprender sobre ello! Pero no espere saber más que el electricista: recuerde que las IAs se equivocan. El objetivo es tener un mínimo de conocimiento para lograr conversar con el electricista de una manera mínimamente "orientada".
"An electrician came to my home and said I need to install a residual-current device (RCD). Explain what it is and what its function is."4) Prompt con persona
En este prompt, además de comando, objeto, parámetro de salida y contexto, tenemos el establecimiento de una persona para la IA. Este es un tipo de prompt MUY ÚTIL para auxiliar en el proceso de aprendizaje — y, no por azar, uno de los prompts más utilizados.
"You will act as an expert radiology instructor. I have 20 days to learn the fundamentals of ultrasonography and you will be my teacher: build a detailed learning schedule for those 20 days, covering the key ultrasound concepts that an excellent introductory module should include."5) Prompt compuesto
A continuación combinamos algunas de las estrategias de los prompts listados arriba.
"You will act as an English teacher specialized in teaching English as a foreign language. I have 20 minutes per day and you will be my instructor: build a detailed learning plan with basic, intermediate and advanced English content so that a foreign learner can communicate adequately.

We can begin immediately, and your first task is to assess my current English level. Ask the necessary questions to evaluate my skills."
Note, en el ejemplo de arriba, que la estructura del prompt establece que el modelo de IA debe iniciar sus outputs con preguntas para evaluar nuestro nivel de inglés. Ese tipo de
técnica de prompt es conocida como "prompt reverso" y puede ser extremadamente útil para evaluar nuestro conocimiento, desempeño o incluso para hacernos reflexionar sobre el asunto en cuestión en el prompt. Vea otro ejemplo abajo:
Eres un coach de carrera sénior con 20 años de experiencia en transiciones profesionales, especializado en ayudar a profesionales de TI, ingeniería y áreas creativas a cambiar de carrera con claridad y confianza. Tu estilo es empático, directo y basado en evidencias, inspirado en métodos como el Ikigai y GROW.

**Contexto**: El usuario está considerando una transición profesional — cambiar de empleo, de sector o incluso emprender — pero necesita reflexionar profundamente para evitar arrepentimientos. Estamos en una conversación iterativa para trazar el camino ideal.

**Objetivo**: Guiar al usuario a reflexionar sobre su momento actual, identificar motivaciones reales, fortalezas y obstáculos, creando un plan personalizado de transición en etapas claras y accionables.

**Tareas (reverse prompting)**: NO des consejos ni planes todavía. En cambio, haz 5-7 preguntas esenciales y abiertas para recolectar información clave. Agrúpalas en categorías (ej.: "Sobre tu situación actual", "Motivaciones y valores", "Habilidades y red"). Después de las respuestas del usuario, úsalas para generar un informe de reflexión y un plan inicial.

Preguntas iniciales para hacer AHORA:
1. ¿Cuál es tu profesión actual, cuánto tiempo de experiencia tienes y qué es lo que más/menos te gusta de ella?
2. ¿Por qué quieres hacer una transición ahora? Describe los detonantes emocionales o prácticos.
3. ¿Cuáles son tus habilidades principales (técnicas y soft skills) y los logros que más te enorgullecen?
4. ¿Qué sería un "éxito" en la nueva carrera para ti (ej.: salario, flexibilidad, impacto)?
5. ¿Qué obstáculos reales prevés (finanzas, familia, mercado)?
6. Describe tu red de contactos profesionales y quién podría ayudar en esta transición.
7. En una escala de 1-10, ¿qué tan listo(a) te sientes para cambiar en los próximos 6-12 meses?

Analiza las respuestas y confirma la comprensión antes de continuar.
Ventana de contexto
Tal vez usted ya haya notado que, en conversaciones muy largas, la IA a veces parece quedar confusa y devolver contenidos relativamente aleatorios, como si hubiera olvidado lo que fue dicho al inicio de la conversación. Esto sucede por causa de laventana de contexto. La mejor forma de entender la ventana de contexto es imaginándola como una "memoria de corto plazo" de la IA. En la práctica, es la cantidad máxima de información (texto, archivos, imágenes) que ella consigue procesar simultáneamente en una única interacción. Esa ventana de contexto se mide en miles o millones de tokens: explicando mal, tokens son las unidades fundamentales de procesamiento que las IAs usan. En el procesamiento del prompt, las palabras son transformadas en pedazos menores (tokenización), de forma que una palabra grande puede tener varios tokens y una palabra pequeña puede equivaler a un token (y esto varía según el idioma). Para fines prácticos, aunque técnicamente incorrecto, podemos considerar palabras = tokens.
Cuando esa ventana "se llena", la IA tiene dificultad para rescatar las informaciones anteriores, lo que puede llevar al olvido de instrucciones importantes, principalmente aquellas que quedaron en el medio de la conversación. En general, la IA suele procesar mejor las informaciones del inicio y del fin de la conversación (los primeros y últimos prompts), lo que puede llevar a la pérdida de instrucciones fundamentales que quedaron en el "medio" de la conversación.
Hay una variación considerable entre el tamaño de las ventanas de contexto de cada herramienta de IA. El Gemini, por ejemplo, posee una de las mayores janelas de contexto, llegando a 1 millón de tokens. El Claude (modelos Opus 5 y Sonnet 5) también trabaja con hasta 1 millón de tokens vía API, mientras el ChatGPT (actualmente en la familia GPT-5.6) llega a más de 1 millón de tokens por la API — aunque, en la versión web más común (la aplicación de suscripción estándar), la ventana efectiva suele quedar bien menor, algo entre 250 y 400 mil tokens. Vale recordar: esos números cambian con frecuencia, así que trátelos como una referencia de orden de grandeza, no como un valor fijo.
Consejo práctico: Para evitar alucinaciones en proyectos largos con las IAs convencionales (GPT, Claude), no mantenga el mismo chat infinitamente. Cuando sienta que el asunto cambió o que la conversación quedó muy extensa, pida un resumen e inicie un novo chat. Eso "limpia" la ventana de contexto, manteniendo la IA afilada.
Use the prompt below to generate that migration summary:
[CONTEXTO] Estamos en una interacción larga sobre [INSERTAR TEMA, ej.: el desarrollo de un protocolo]. Para no perder detalles importantes y para limpiar la ventana de contexto en un chat nuevo, necesito que condenses todo lo que hemos hecho.

[TAREA] Genera un "Resumen de Estado Actual" detallado que contenga:
1. El objetivo principal que estamos persiguiendo.
2. Todas las decisiones ya tomadas y validadas (lo que ya está listo).
3. El estado actual exacto de dónde nos detuvimos.
4. Los próximos pasos inmediatos que estaban pendientes.
5. Las restricciones o preferencias de estilo que ya te he enseñado en esta conversación.

[FORMATO] El resultado debe ser un texto estructurado, listo para copiarse y pegarse como el PRIMER prompt de un chat nuevo, para que la nueva instancia de la IA continúe el trabajo exactamente donde lo dejamos, sin perder contexto.
Anatomía del prompt "perfecto"
A partir de la discusión de la sección anterior, entendemos que existen prompts que son más o menos adecuados a una tarea específica. A partir de ahí, es frecuente que surja la pregunta: ¿existe un prompt "perfecto"? La respuesta es: no existe un único perfecto, pero existen componentes que, cuando bien organizados, producen excelentes resultados para la mayoría de las tareas que necesitamos resolver.
Elementos de un prompt bien construido
- Persona — quién la IA debe "encarnar" al responder.
- Objetivo — qué usted quiere alcanzar con aquel output.
- Contexto — las informaciones de fondo que vuelven la tarea específica.
- Tarea — el comando concreto, lo que la IA debe hacer.
- Restricciones — lo que debe (o no debe) aparecer en la respuesta.
- Formato de salida/output — cómo el resultado debe ser estructurado (tabla, lista, texto corrido...).
Note que no todos los componentes son obligatorios. Por ejemplo, para una tarea simple, como generar un texto, usted puede no necesitar persona, contexto o restricciones.
Ejemplo 1
Persona:
Actuarás como responsable de recursos humanos.

Objetivo:
Crear criterios objetivos para evaluar el desempeño administrativo.

Contexto:
Un equipo administrativo compuesto por asistentes y analistas.

Tarea:
1. Definir criterios medibles.
2. Proponer una escala de evaluación.
3. Sugerir una periodicidad de evaluación.

Formato de respuesta:
Tabla con criterios, descripción y escala de puntuación.
Ejemplo 2
Persona:
Actuarás como consultor de comunicación corporativa.

Objetivo:
Redactar una comunicación interna sobre la implementación de un nuevo sistema administrativo.

Contexto:
Colaboradores con diferentes niveles de familiaridad con la tecnología.

Tarea:
1. Explicar el motivo del cambio.
2. Destacar beneficios operativos.
3. Informar los próximos pasos.

Restricciones:
Use un lenguaje simple y accesible.
Evite jergas y términos técnicos.

Formato de respuesta:
Comunicado institucional en texto continuo.
Ejemplo 3
Persona:
Actuarás como responsable de compliance interno.

Objetivo:
Evaluar riesgos administrativos en un proceso de contratación de proveedores.

Contexto:
Contrataciones recurrentes de servicios tercerizados.

Tarea:
1. Identificar riesgos operativos.
2. Identificar riesgos legales básicos.
3. Proponer controles administrativos simples.

Formato de respuesta:
Tabla seguida de una breve conclusión.
De lo simple a lo complejo: tres niveles del mismo prompt
De manera general, los prompts pueden ser más o menos extensos y pueden contener más o menos elementos. Hay contextos en que prompts simples y directos funcionarán muy bien y en otros usted necesitará prompts con muchos más detalles y elementos. Vea abajo algunos ejemplos más:
Basic
You are a text editor. Review the abstract below for grammar, cohesion and coherence. Structure it into paragraphs.Intermediate
You are a scientific editor specialized in medicine with 15 years of experience in international journals.

This abstract will be submitted to JAMA as a structured abstract.

Review the abstract below for:
- Grammar and clarity in scientific English
- IMRAD structure (Introduction, Methods, Results, Discussion)
- A maximum length of 300 words

Expected format: paragraphs with bold subsection headings.
Advanced
[SYSTEM]
You are a senior scientific editor specialized in medicine with 15 years of experience in international journals (JAMA, Lancet, NEJM). Your task is to perform a critical editorial review.

[CONTEXT]
This abstract will be submitted to JAMA. Audience: editors, reviewers and international clinical readers. Expected standard: editorial excellence.

[ACTION]
Review and rewrite the abstract below while preserving scientific integrity and maximizing clarity.

[POSITIVE CONSTRAINTS]
- Structure: IMRAD with bold subsection headings
- Length: maximum 300 words
- Style: formal scientific English, active voice whenever possible
- Citations: use bracketed numbers [1], [2], etc.
- Data: preserve all original numbers and values exactly

[NEGATIVE CONSTRAINTS]
- Do not speculate beyond the presented data
- Do not use nonstandard jargon or undefined abbreviations
- Do not alter the scientific conclusions; only clarify expression

[EXPECTED FORMAT EXAMPLE]
**Introduction.** [2-3 sentences on the problem and the knowledge gap]
**Methods.** [Design, population, intervention]
**Results.** [Main findings with values]
**Discussion.** [Clinical meaning, limitations, next steps]

[VALIDATION]
Before answering, confirm:
✓ Does every claim have a supporting source or citation?
✓ Is the length within 300 words?
✓ Is the IMRAD structure preserved?

If any criterion is not met, state which one before delivering the revision.
Nivel avanzado: lista de verificación de calidad
Para evaluar si su prompt está "lo bastante bueno", use este checklist:
"Responda sobre la eficacia de la vitamina D en COVID-19. DEBE proporcionar respuestas basadas únicamente en evidencia científica. Cite sus fuentes explícitamente."
Aunque son semánticamente idénticas, la versión A tiende a producir un cumplimiento significativamente mayor porque el modelo lee primero la restricción y la trata como política prioritaria de la tarea.
Recencia y primacía
Los modelos de lenguaje suelen otorgar más peso a la información del inicio y del final del prompt:
- Las instrucciones del comienzo influyen más en la "política general" de la respuesta. Si usted define allí el tono, la persona o las restricciones fundamentales, el modelo las tratará como principios guía (efecto de primacía).
- Las instrucciones del final pesan más sobre la acción inmediata. Si lo último que usted dice es "responda en 100 palabras", esa restricción recibirá prioridad en la salida actual incluso si antes había tensiones o matices distintos (efecto de recencia).
Esto conduce a un problema práctico: las instrucciones que quedan en medio de un prompt largo suelen perderse con mayor facilidad. Son las que presentan menor tasa de cumplimiento.
Ejemplo:
Las restricciones sobre fuentes (solo PubMed, últimos 5 años) muestran menor cumplimiento cuando se colocan en el medio que cuando se colocan justo después de la persona — ese pequeño ajuste puede representar un desempeño significativamente mejor.
Ejemplo:
Inicio: "DEBE citar únicamente fuentes primarias."
Final: "Antes de finalizar, confirme que TODAS las afirmaciones incluyen una cita de fuente primaria."
ℹ️
Recordatorio: otra anatomía de un prompt sólido
(1) Persona — al inicio, define "quién es usted"
(2) Restricciones fundamentales — justo después de la persona
(3) Contexto/Problema — en el medio
(4) Formato esperado — cerca del final
(5) Acción específica — al final, como activación final
(6) Resumen/repetición de lo crítico
Chunking del prompt
En determinadas situaciones, usted puede tener que hacer un prompt obligatoriamente extenso. Una de las mejores técnicas para ejecutar un prompt largo con buenos resultados es dividirlo en bloques/secciones y usar formatos específicos (markup, JSON). En vez de un prompt de 2.000 palabras con varias instrucciones esparcidas, cree:
BLOQUE 1: [Persona + restricciones fundamentales]
BLOQUE 2: [Contexto + problema]
BLOQUE 3: [Acción + formato esperado + validación]
El toque final
Existen técnicas más avanzadas para verificar el output (que aparecen en otra sección de este e-book), pero ya puede añadir al final de un prompt factual una instrucción sencilla: "Revise el output antes de transcribirlo y, si detecta alguna inconformidad con el input solicitado, reinicie el proceso. Continúe hasta que no existan incoherencias ni incongruencias."
Ejemplo: "[Inserte aquí su prompt de sistema] Para confirmar que leyó estas instrucciones, comience su respuesta con: 'Entendí que debo [resumen breve de la instrucción crítica].' Luego continúe con la respuesta."
📐 Orden recomendado para prompts profesionales
Inicio (primacía): Persona + restricciones fundamentales/absolutas
Contexto: Contexto, propósito, audiencia
Acción: Qué hacer (comando específico)
Detalles: Formato, ejemplos, restricciones negativas
Final (recencia): Validación e instrucción final (en prompts extensos, puede ser útil un breve resumen de lo solicitado)
GPT: personalización general, Proyectos y GPTs
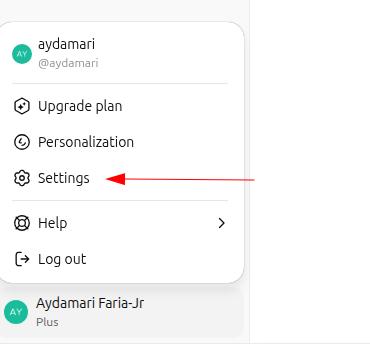
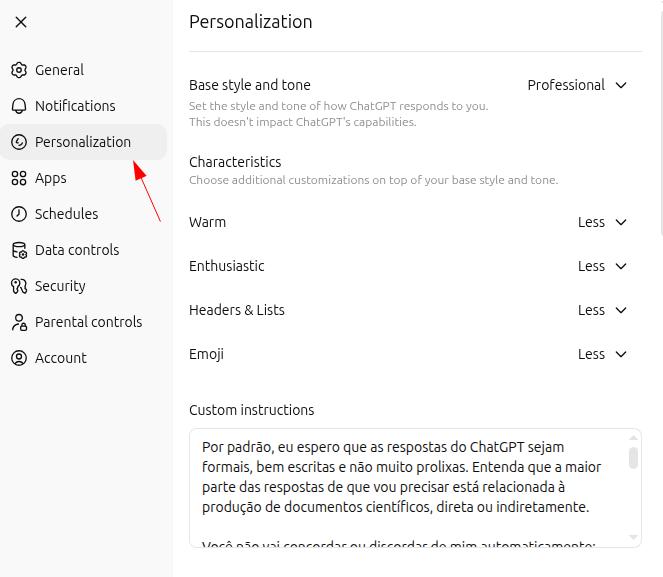
Es posible personalizar el GPT de acuerdo con el uso cotidiano y volverlo aún más adecuado a nuestras necesidades. Acceda a las configuraciones del ChatGPT y vaya a "personalización":
Prompt "maestro" general
Por defecto, espero que las respuestas sean formales, concisas y bien estructuradas. La mayoría de mis solicitudes se relaciona con la producción de documentos científicos, directa o indirectamente.

No concuerde ni discorde automáticamente conmigo. Analice mis prompts y responda de la forma más objetiva posible.

Para asegurar que estas directrices se cumplan de verdad, siempre iniciaré mis interacciones con "let's work" o "vamos trabalhar" y espero que me dirija como ["[SU NOMBRE]"]. En esas situaciones, las respuestas deben ser absolutamente neutrales: no busque concordancia ni discrepancia con mis dudas, pensamientos u opiniones. Analice críticamente el texto proporcionado y presente la respuesta más adecuada, evitando rigurosamente errores, imprecisiones y alucinaciones.
Proyectos: espacios de trabajo personalizados
La propia OpenAI define los Proyectos como "espacios de trabajo" especializados. Imagine que usted tiene múltiples actuaciones en una misma empresa o en empresas diferentes: puede configurar un Proyecto para cada una, con instrucciones y archivos personalizados para cada contexto.
Cada proyecto permite un prompt mestre asociado a aquella actividad, además de archivos de referencia. La combinación de un prompt preciso con documentos relevantes transforma los proyectos en verdaderos asistentes personalizados — y muy útiles. En tanto: el Gemini los llama "Gems"; el Claude los llama "Projects". La mayoría de las IAs posee algún tipo de personalización semejante.
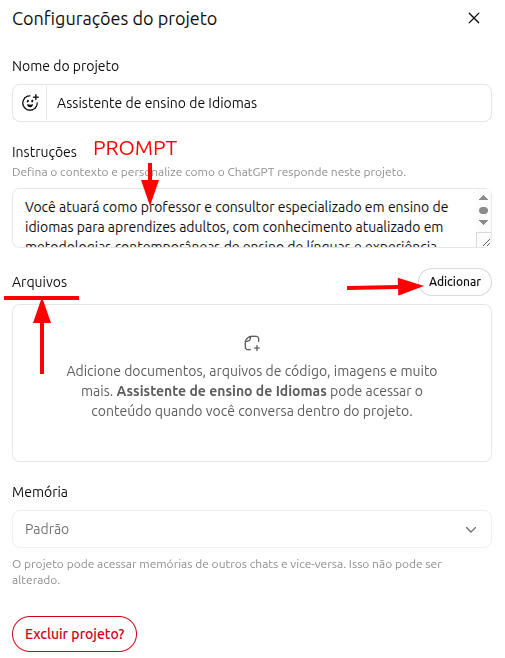
Ejemplo de prompt para un Proyecto de enseñanza de idiomas
Actuarás como profesor y consultor especializado en la enseñanza de idiomas para adultos, fundamentado en metodologías contemporáneas como Task-Based Learning, Communicative Language Teaching y enfoques afines.

Utilizarás andragogía y neuroeducación para diseñar programas de instrucción en cualquier idioma, priorizando la competencia comunicativa y la fluidez funcional antes que la precisión gramatical.

Las tareas incluyen:
- Elaboración de programas estructurados en arquitectura modular, adaptados al nivel CEFR (A1-C2) y a los objetivos específicos del estudiante
- Conducción de conversación práctica, con inmersión progresiva
- Producción de ejercicios basados en spaced repetition, interleaving y retrieval practice
- Retroalimentación inmediata, específica y orientada a la acción
- Evaluación formativa continua con ajuste dinámico de la dificultad
Diferencia entre Proyectos y GPTs
Lo que hoy se llama "GPT" dentro del ChatGPT se llamaba "plugin" y era considerablemente diferente de los Proyectos. Con el avance de ambas herramientas, se han vuelto cada vez más semejantes. En términos prácticos: entienda los GPTs como "ambientes de trabajo" personalizados hechos para ser compartidos con otras personas, mientras que los Proyectos son hechos para uso individual, aunque puedan ser compartidos.
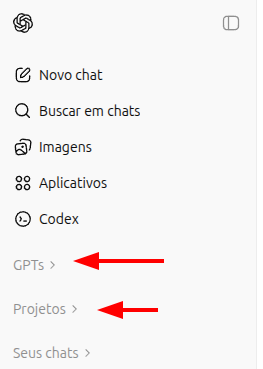
Atención — cambio reciente: desde agosto de 2026, OpenAI ha restringido la creación de nuevos GPTs a las cuentas de workspace pagas (Business, Enterprise o Education); las cuentas personales — incluidas Plus y Pro — ya no pueden publicar GPTs nuevos, solo usar y editar los que ya existían antes del cambio. Si ya tenías GPTs creados, siguen funcionando con normalidad. normalmente.
Deep Research
La búsqueda estándar (Google o IA común) es como preguntar a un bibliotecario sobre un tema y que él le entregue el libro más reciente que leyó. Usted recibe información rápida, pero limitada. El modo Deep Researches como contratar un investigador profesional: él (1) crea un plan de investigación, (2) lee decenas de artículos/fuentes, (3) cruza las informaciones contradictorias, (4) busca fuentes primarias para desempatar y (5) escribe un informe consolidado. Demora más — de algunos minutos a media hora —, con resultado incomparablemente más profundo.
El Deep Research es útil en los dos extremos del conocimiento: cuando usted "no sabe nada" (para construir repertorio mínimo antes de una reunión con un especialista) y cuando usted "sabe bastante" (para actualizarse rápidamente sobre lo más reciente de la literatura). Especifique las fuentes que el Deep Research debe priorizar: artículos con texto completo en PubMed, jurisprudencias de un tribunal específico, PCDTs del Ministerio de Salud, etc.
Realizarás una investigación profunda sobre salud mental y el uso de LLMs (modelos de lenguaje de gran tamaño).

Incluye ejemplos o casos, riesgos, prevalencia global y brasileña de los trastornos mentales más frecuentes, y discute cómo el uso de LLMs puede o no representar una amenaza para la población general.

Incluye también la cobertura periodística del tema y cómo las grandes empresas tecnológicas están tratando el asunto.

Además, busca y analiza artículos científicos relacionados con el tema (criterios EBM con nivel de evidencia A/B, solo artículos con texto completo disponible en PubMed/Medline) y resume sus hallazgos principales.
Comparativo: Deep Research vs. Deep Search
| IA / Herramienta | Nomenclatura | Diferencial principal |
|---|---|---|
| ChatGPT (OpenAI) | Deep Research | La referencia actual. Genera reportes largos y estructurados. Excelente en descomponer problemas complejos. |
| Gemini (Google) | Deep Research / Grounding | La segunda mejor opción entre las más conocidas. |
| Perplexity | Pro Search (Deep Search) | Enfocado en verificación de hechos y noticias recientes. |
| Claude (Anthropic) | Projects / Analysis | No se enfoca en buscar en la web de forma nativa, sino en analizar en profundidad las bibliotecas de documentos que usted envía. |
| Kimi (Moonshot) | Kimi Research | Buen producto; limitado a 1 Deep Research por día en la versión gratuita. |
| Grok (xAI) | Deep Search (Real-time) | Posiblemente la mejor opción para noticias extremadamente recientes (breaking news). |
| GLM (Zhipu/Z.ai) | Búsqueda web integrada + AutoGLM-Web | No tiene un producto "Deep Research" propio con ese nombre; el chat (chat.z.ai) ya navega y busca en la web durante la respuesta, y la extensión AutoGLM-Web amplía eso a navegación autónoma en páginas. Trátelo como un intermediario entre una búsqueda común y un Deep Research completo. |
Resumen de la elección: ¿Necesita un dosier técnico? ChatGPT ou Gemini. ¿Necesita chequear hechos y noticias? Perplexity ou Grok. ¿Necesita analizar 50 PDFs que usted ya tiene? Claude ou Gemini Notebook (que veremos a continuación).
Nota: el ZCode, de Z.ai (mencionado en la grada de herramientas agénticas), no es una herramienta de investigación — es un ambiente de desarrollo agéntico para programación con los modelos GLM, equivalente al Claude Code o al Codex. Por eso no aparece en esta tabla de Deep Research.
Canvas ("pizarra")
El modo Canvas le permite editar y revisar el contenido en construcción. Trabajemos con un ejemplo práctico: usted necesita revisar un documento que creó (una acta, un artículo, un capítulo de libro...) y, en vez de simplemente solicitar a la IA que edite por usted, puede abrir el documento en Canvas y editarlo en conjunto con la IA, editando directamente lo que entienda que debe ser editado y solicitando a la IA que haga otras ediciones (resumir un párrafo, expandir una sección...).
Atención a un cambio reciente: el ChatGPT removeu el modo Canvas de sus modelos principales en 2026 — la edición de texto y código pasó a ocurrir directamente dentro de la propia conversación, en "bloques" editables, sin un panel separado. Hoy, el Gemini es la herramienta de referencia para ese tipo de espacio de edición colaborativa dedicado, y es en él que el ejemplo de abajo funciona mejor.
El Canvas puede ser una herramienta poderosísima para edición de códigos, páginas (html) y hasta documentos. Yo prefiero editar mis propios textos y compartiré el prompt que uso en el campo de abajo para que usted pueda copiarlo y adaptarlo a su realidad:
Revisarás el texto adjunto en busca de posibles errores gramaticales y de digitación. Evalúalo en términos de coherencia y cohesión, pero sin editarlo directamente: marcarás con formato tachado las partes del texto que sugieres eliminar y, al lado, incluirás tus sugerencias en negrita, para que yo pueda identificar las partes que deben ajustarse y juzgarlas directamente.
Vale recordar que ese tipo de recurso cambia rápido — el propio Canvas del GPT existió y fue descontinuado dentro del período de vida de este e-book. La mejor manera de entender y aprender los usos de la herramienta es practicando, ¡entonces manos a la obra!
Gemini Notebook (antiguo NotebookLM)
En julio de 2026, Google renombró el NotebookLM a Gemini Notebook, como parte de la integración más cercana con el resto del ecosistema Gemini. Es la misma herramienta, con el mismo propósito — si usted usaba el NotebookLM, sus notebooks continúan exactamente donde estaban, y los enlaces antiguos continúan funcionando. En este e-book, uso "Gemini Notebook" de ahí en adelante, pero no se extrañe si todavía encuentra el nombre antiguo por ahí.
Es mi herramienta de IA preferida, y voy a explicar los motivos. Há algún tiempo, quedó famosa por la posibilidad de generar "resúmenes en audio" — que, a pesar de ser un excelente recurso, no es el motivo principal por el cual la uso tanto.
Volvamos a la conversación sobre alucinaciones: por medio de ajustes en el prompt y con el anclaje (grounding) de las fuentes, logramos disminuir al máximo la tasa de alucinaciones. Es exactamente eso lo que hace el Gemini Notebook: él solo consulta — y responde — a partir de las fuentes que usted elija utilizar.
Cuando usted crea un notebook, la primera pantalla es la de elección de fuentes. Puede añadir documentos, archivos del Drive, Google Docs (incluyendo planillas), vídeos de YouTube, URLs de sitios y archivos de audio. Todo ese material se vuelve su fuente, y todas las respuestas extraídas de sus prompts vendrán exclusivamente de las fuentes que usted añadió. Si usted ya ha oído hablar de RAG (retrieval augmented generation), es más o menos eso lo que hace el Gemini Notebook — reduciendo al mínimo posible los errores y alucinaciones.
Cómo añadir fuentes en el Gemini Notebook
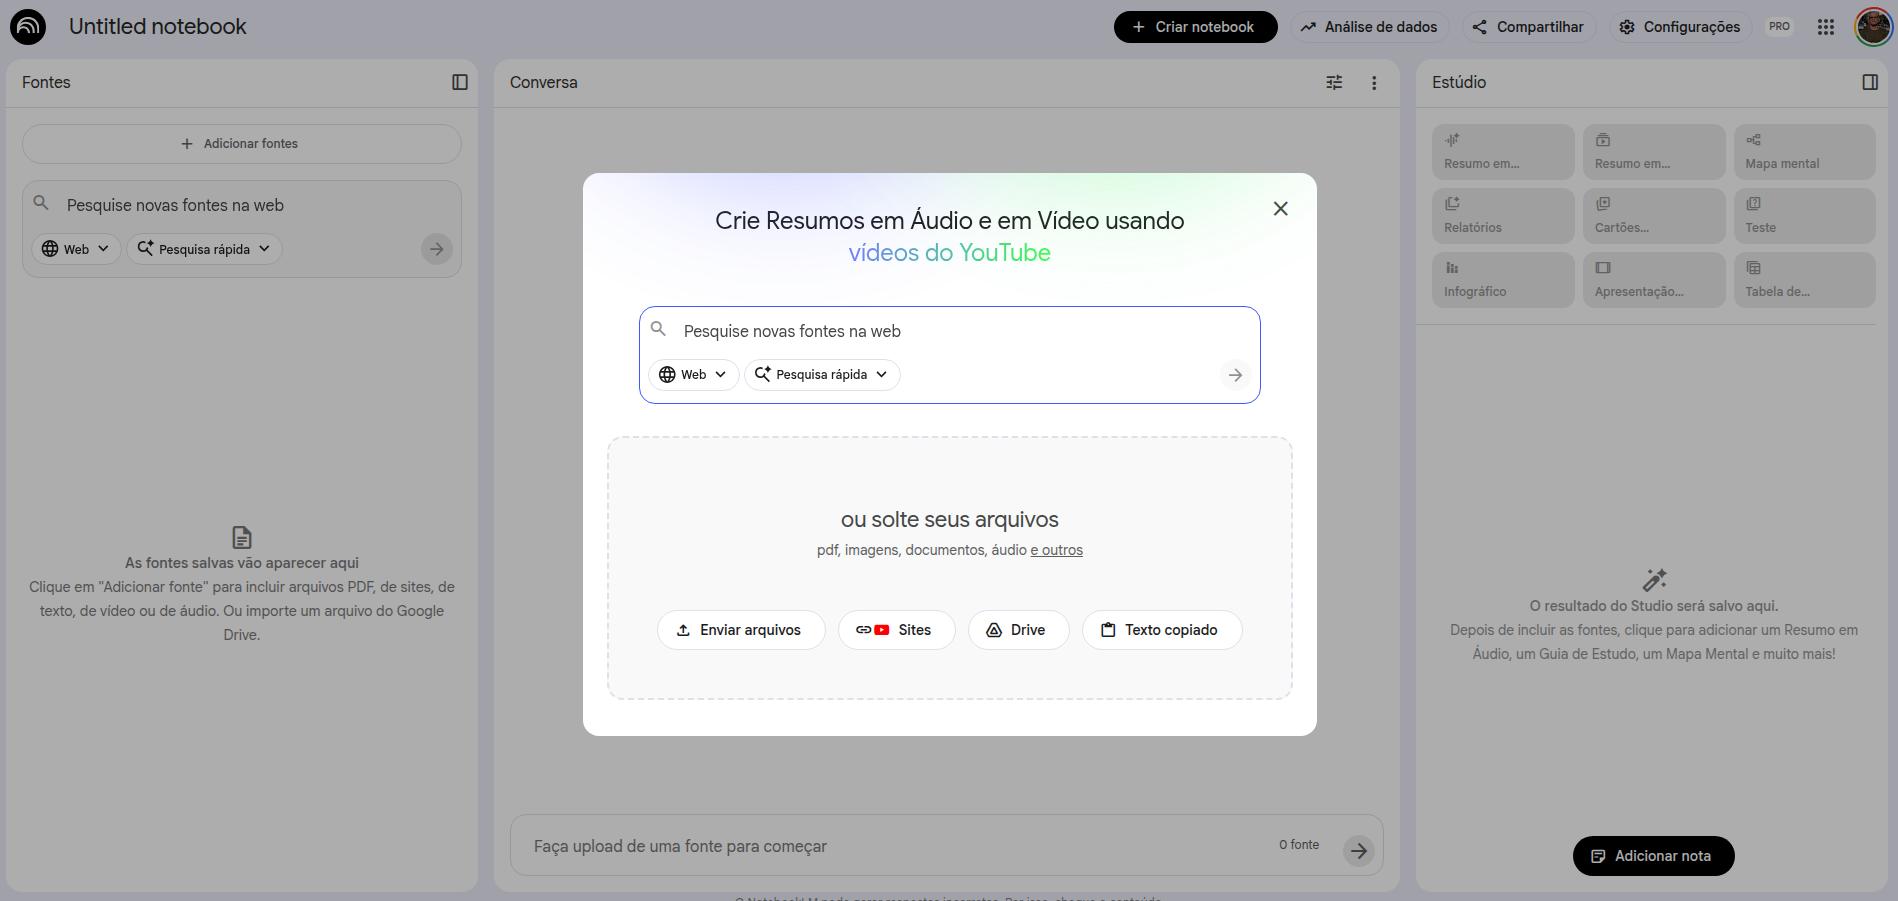
Una vez añadidas las fuentes, la interfaz se organiza de la siguiente forma: a la izquierda, las fuentes añadidas (usted puede removerlas o añadir otras); al centro, la interfaz de prompt; a la derecha, los recursos de interacción que el Gemini Notebook provee.
Recursos disponibles en el Gemini Notebook
El panel de recursos incluye:
- Resumen en audio (podcast con dos presentadores que discuten sus fuentes)
- Guía de estudio (con preguntas de opción múltiple, respuestas cortas y preguntas abiertas)
- FAQ (preguntas frecuentes sobre el contenido)
- Resumen y línea de tiempo
- Documento de briefing (resumen ejecutivo)
- Mapa mental
- Infográficos
- Flashcards y quiz
- Análisis de datos con código (recurso más reciente: un ambiente seguro en la nube que escribe y ejecuta código para cruzar sus fuentes, generando gráficos, planillas y informes a partir de ellas)
Casi todos los recursos presentan un ícono de "lápiz" — lo que significa que usted puede editar las instrucciones estándar de aquel recurso, insertando un prompt personalizado.
Edición de recursos — ejemplo para audio
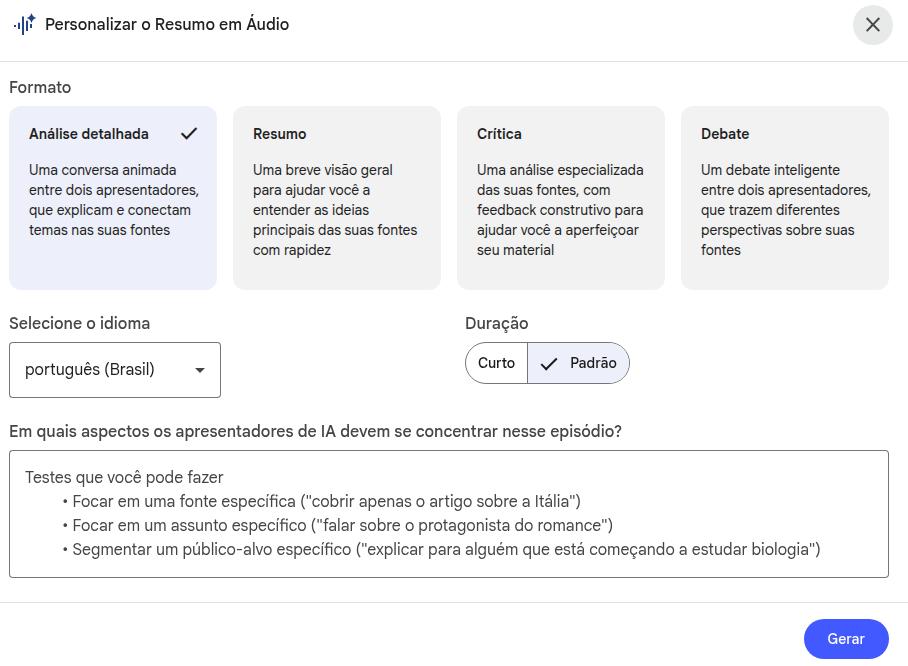
Producirás un audio tan detallado y extenso como sea posible, abordando los detalles metodológicos con rigor y precisión: describe en detalle cómo fue el montaje de la estructura del producto desarrollado, los detalles del prompt de debate (si fue una estrategia de IA agéntica con múltiples personas o si, de hecho, se utilizaron agentes diferentes). Por último, detente en los resultados: describiéndolos en detalle y explicando sus impactos para la salud.Ventana de contexto extensa
El Gemini Notebook ofrece una ventana de contexto de 1 millón de tokens, permitiendo la interacción con múltiples documentos extensos simultáneamente — libros enteros, artículos científicos, transcripciones de reuniones. Diferente de las IAs convencionales, él fue diseñado específicamente para "consultar profesionalmente" múltiples archivos: sus fuentes quedan separadas de la ventana de conversa, pero totalmente accesibles al modelo. Eso permite que usted converse largamente con los documentos, sin que el tamaño de ellos entorpezca la memoria de la conversación.
Cada respuesta viene acompañada de la cita precisa del trecho original de su documento, facilitando la verificación y aumentando drásticamente la confiabilidad para uso profesional.
Ecosistema Google: integración y actualización dinámica
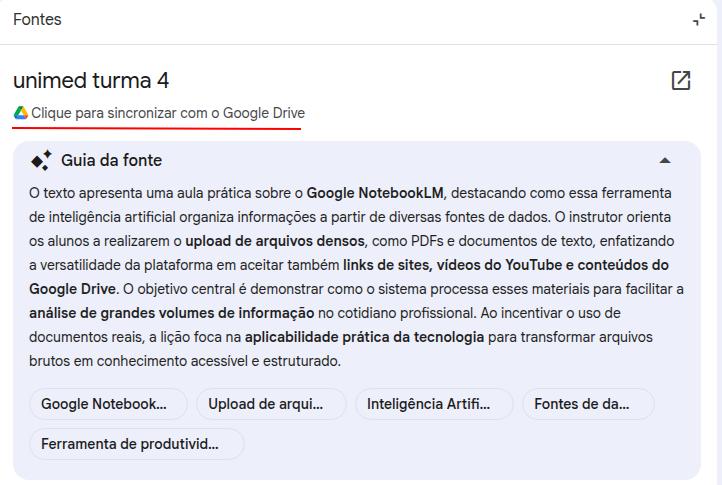
El Gemini Notebook se integra al ecosistema Google, permitiendo usar carpetas y documentos del Google Drive como fuentes. El punto más útil: al conectar un Google Docs como fuente, el Gemini Notebook mantiene el vínculo con el archivo original — que usted puede actualizar cuando quiera. Al detectar que hubo cambios en la última versión, el Gemini Notebook disponibiliza un botón para actualizar la fuente.
Transcripción de audio y video
El Gemini Notebook permite transcribir audios y vídeos de forma integral: basta añadirlos como fuentes y solicitar, vía prompt, la transcripción del material. Usted puede incluir instrucciones de destaque: imagine que grabó una reunión que necesitará ser transformada en acta, o una clase donde el profesor destaca frecuentemente informaciones importantes. Ejemplos:
Transcribe el material fuente de manera íntegra, identificando, siempre que sea posible, a los distintos interlocutores.

Después, redacta un acta formal de la reunión con los siguientes elementos: fecha, participantes identificados, agenda tratada, decisiones tomadas y tareas pendientes con responsables.
Gemini Notebook gratuito vs. pago
Hay diferencias entre las versiones gratuita y paga, modificando la cantidad de notebooks que pueden ser creados, la cantidad de fuentes por notebook, el número de recursos creados/día y, subjetivamente, la velocidad de generación de algunos recursos (impresión personal). Mi sugerencia: inicie trabajando con la versión gratuita y solo después de familiarizarse con la herramienta, migre para la versión paga (si fuera el caso). El nivel pago no se vende separadamente: viene incluido en las suscripciones Google AI Plus, Pro y Ultra.
- Más notebooks y más fuentes por notebook (límites mayores que los de la versión gratuita)
- Más generaciones de resúmenes en audio por día
- Audios más largos y detallados
- Integración más profunda con Google Workspace
- Funciones para compartir notebooks con equipos
- Soporte prioritario y acceso anticipado a nuevas funciones
Atención — cambio de límites en septiembre de 2026: a partir del 2 de septiembre de 2026, Google cambió los límites del Gemini Notebook: en vez de un número fijo de preguntas/recursos por día, el límite ahora se basa en la complejidad y extensión de cada tarea (cuánto texto usted cargó, el tamaño del histórico de la conversa y qué recursos activó). En la práctica: pocas tareas muy complejas pueden agotar su límite más rápido que muchas tareas simples — la app avisa cuando usted está cerca del techo, y los límites se renuevan cada pocas horas. La regla vale tanto para quien usa gratis cuanto para quien paga, pero cuentas pagas continúan teniendo un margen bien más generoso. Aún habrá limitaciones diferentes, para cuentas gratuitas y pagas, en cuanto al número de cuadernos por usuario y de fuentes por cuaderno. Más informaciones en Notebook updates
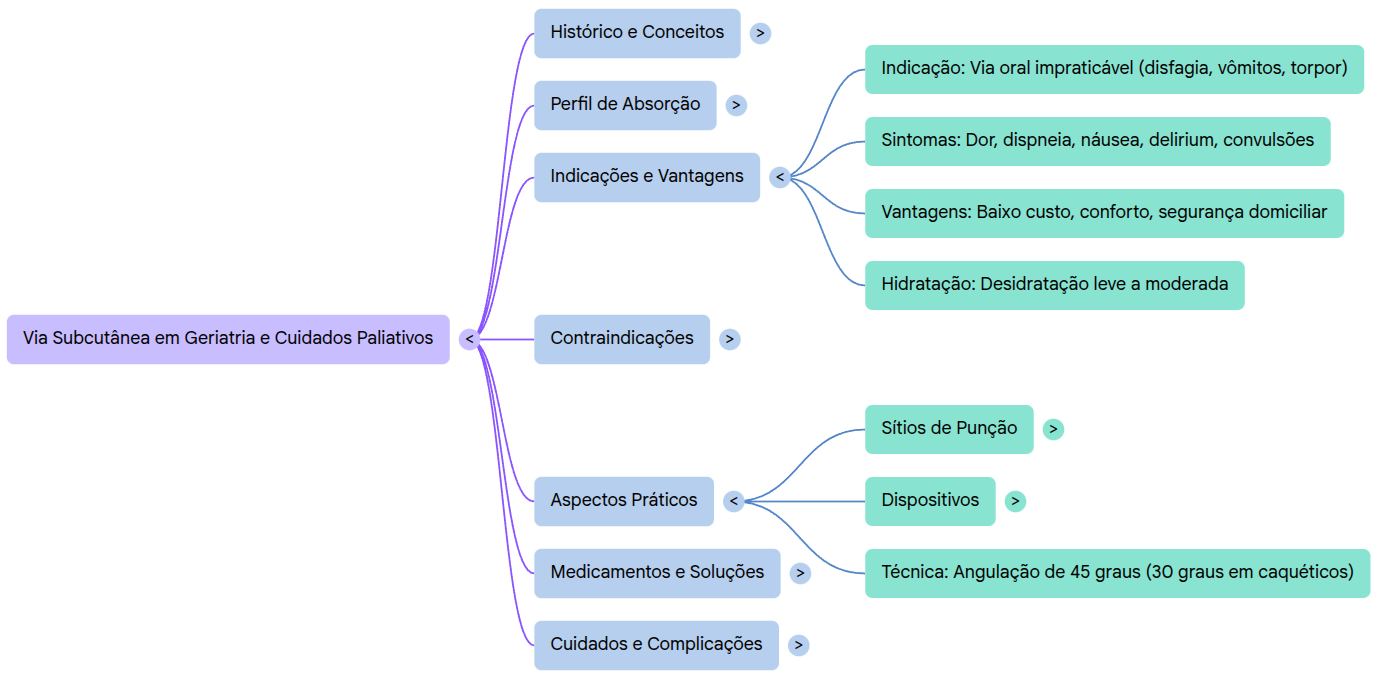
El Gemini Notebook es especialmente útil en contextos académicos. Lo uso bastante para interactuar con textos académicos (artículos en PDF, por ejemplo — y ahora archivos EPUB también)
- Revisión de literatura: añada los artículos seleccionados y use el prompt para sintetizar los principales hallazgos, comparar metodologías o identificar lagunas de conocimiento.
- Estudio de guías: cargue las guías más recientes de una especialidad y haga preguntas clínicas directamente a ellas
- Preparación de presentaciones: use el recurso de Guía de Estudio y FAQ para generar preguntas sobre el contenido de clases o conferencias
- Diario de aprendizaje: mantenga un Google Docs con anotaciones diarias y conéctelo al Gemini Notebook; al final de la semana, genere un resumen o quiz sobre lo que aprendió.
- Dica "pro": use el Gemini Notebook como tutor personalizado. Estudie un artículo y explíqueselo, solicitando que corrija y complemente eventuales puntos críticos en que usted se equivocó o dejó pasar.
OpenEvidence
¿Qué es OpenEvidence?
El OpenEvidence es una plataforma de apoyo a la decisión clínica basada en IA, desarrollada específicamente para médicos y profesionales de la salud. Diferente de los modelos de uso general (como ChatGPT y Gemini), el OpenEvidence fue entrenado y optimizado para consultas médicas, con acceso a literatura médica específica y curada por su equipo editorial.
La plataforma posee acuerdos de contenido con diversas organizaciones de referencia como NEJM (New England Journal of Medicine), JAMA, NCCN (National Comprehensive Cancer Network), Cochrane, Wiley, ACC (American College of Cardiology), ADA (American Diabetes Association) y otras sociedades médicas.
¿Cómo funciona?
El funcionamiento es simple y muy parecido a la lógica detrás de los demás LLMs:
- Usted hace una pregunta clínica en inglés o portugués
- La herramienta busca en sus propias bases de literatura médica
- Devuelve una respuesta con citas de las fuentes originales y enlaces a los artículos
- Puede hacer preguntas de seguimiento dentro de la misma sesión para profundizar
Access it at: www.openevidence.com
Mejores prácticas de prompt para OpenEvidence
Como cualquier herramienta de IA, la calidad de la respuesta depende de la calidad de la pregunta. Para el OpenEvidence, las prácticas de abajo hacen diferencia significativa:
1. Incluya el contexto clínico relevante del paciente
En vez de preguntar genéricamente "¿cuál es el tratamiento de la hipertensión?", proporcione contexto:
68-year-old male with a 10-year history of hypertension, type 2 diabetes, and an eGFR of 45 mL/min/1.73m². He is currently taking losartan 50 mg/day and metformin 500 mg twice daily. Current blood pressure: 155/95 mmHg. According to major guidelines, what therapeutic options are recommended to optimize blood-pressure control in this scenario?2. Especifique el tipo de información deseada
What are the current indications for anticoagulation in non-valvular atrial fibrillation? Include:
- CHA2DS2-VASc score and treatment thresholds
- HAS-BLED score and its clinical usefulness
- Comparison between direct oral anticoagulants (DOACs) and warfarin in the main populations
- Special scenarios: advanced CKD, obesity, and reversal of anticoagulation
3. Solicite nivel de evidencia y calidad de los estudios
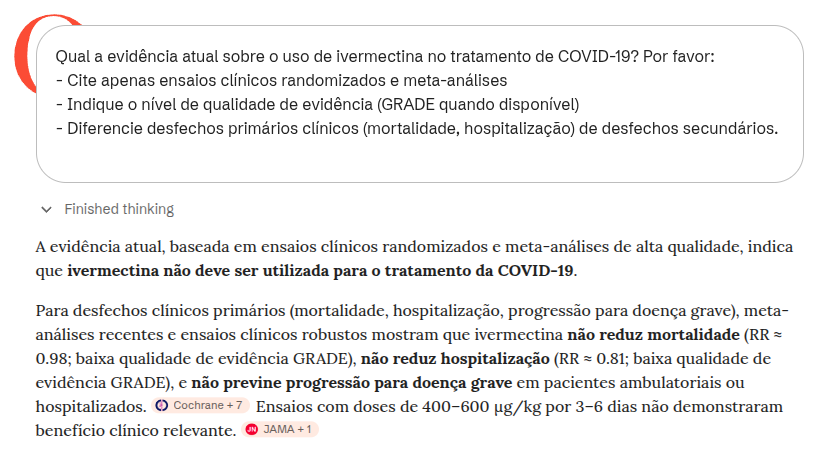
What is the current evidence on the use of ivermectin for treating COVID-19? Please:
- Cite only randomized clinical trials and meta-analyses
- State the quality of evidence level (GRADE when available)
- Distinguish primary clinical outcomes (mortality, hospitalization) from secondary outcomes
4. Compare directamente opciones terapéuticas
Compare the efficacy and safety of SGLT2 inhibitors versus GLP-1 receptor agonists in patients with type 2 diabetes and established cardiovascular disease, based on randomized clinical trials with hard cardiovascular outcomes (MACE, cardiovascular mortality, hospitalization for heart failure).5. Use preguntas de seguimiento para profundizar
El OpenEvidence permite preguntas de seguimiento en la misma sesión. Por ejemplo, tras obtener una respuesta sobre tratamiento inicial, usted puede preguntar:
What if this patient also has heart failure with reduced ejection fraction (HFrEF)? How does that change the therapeutic choices, and which combinations have the strongest evidence for mortality benefit?Cautelas fundamentales en el uso de OpenEvidence
El OpenEvidence es una herramienta poderosa, pero su uso inadecuado puede llevar a errores clínicos. Tres cautelas son especialmente importantes:
1. El prompt orienta la respuesta y puede sesgarla
La manera como usted construye el prompt influencia directamente lo que la herramienta presenta. Si usted pregunta "¿cuáles son las evidencias a favor del uso de X?", la herramienta tenderá a presentar evidencias favorables — aun cuando existan evidencias contrarias relevantes y de mayor calidad metodológica. Preguntas más neutras ("¿cuáles son las evidencias sobre el uso de X?") generan respuestas más equilibradas. Formular sus preguntas de forma neutra y verificar activamente si existen evidencias contrarias es una buena práctica.
2. La herramienta puede confundir desenlaces primarios con desenlaces secundarios
Un error frecuente — tanto en usuarios cuanto en la herramienta — es tratar desfechos sustitutos (laboratoriales, microbiológicos, radiológicos) como equivalentes a desfechos clínicos duros. Por ejemplo: un antibiótico puede "erradicar" una bacteria (desfecho microbiológico) sin mejorar la sobrevida del paciente (desfecho clínico). Una droga puede reducir la hemoglobina glicada (desfecho laboratorial) sin reducir mortalidad cardiovascular. Cuestione siempre: ¿el estudio citado mide el desfecho que importa para mi paciente?
3. Saber que una evidencia existe y saber interpretarla son cosas muy diferentes
El OpenEvidence puede citar un ensayo clínico randomizado sin contextualizar adecuadamente su calidad metodológica, tamaño de efecto real, aplicabilidad a su paciente o riesgo de sesgo. Conceptos como NNT (número necesario para tratar), intervalos de confianza, heterogeneidad de meta-análisis y calidad GRADE son esenciales para interpretar correctamente las evidencias disponibilizadas. La herramienta apoya la decisión clínica; no la sustituye.
Cautela adicional: la herramienta no sustituye su juicio clínico individualizado
Las respuestas del OpenEvidence se basan en poblaciones de estudios que pueden no reflejar las características específicas de su paciente (comorbilidades, interacciones medicamentosas, valores y preferencias). No entienda cualquier herramienta de IA como "oráculo supremo" — ni el OpenEvidence.
Precauciones en el uso de herramientas de IA
Aunque las IAs sean herramientas poderosas, su uso exige responsabilidad y conocimiento de sus limitaciones, especialmente en áreas críticas como la salud. A continuación destacamos cuatro puntos de atención fundamentales.
1) Alucinación (Hallucination)
El término "alucinación" en la IA se refiere a la generación de informaciones que parecen correctas y son presentadas con alta confianza, pero que son falsas o inventadas. Esto ocurre porque el modelo prevé la próxima palabra más probable, no necesariamente la verdad. En salud, esto puede significar la invención de conductas, dosis de medicamentos o citas de artículos que no existen. Verifique siempre las fuentes.
2) Riesgo de sesgo (Bias)
Los modelos de IA son entrenados en vastos conjuntos de datos de la internet, que contienen los prejuicios y sesgos de la sociedad. Esto puede resultar en respuestas que perpetúan estereotipos de género, raza o socioeconómicos, o que presentan sesgo en diagnósticos médicos (por ejemplo, subdiagnosticando ciertas condiciones en grupos demográficos específicos). Esté atento a esas distorsiones.
3) El paradigma de la "caja negra" (Black Box)
No sabemos exactamente como o por que una IA llegó a determinada conclusión. No sabemos qué materiales fueron utilizados en el entrenamiento ni qué fuentes específicas embasaron una respuesta particular. Además, los procesos internos de las redes neuronales son complejos y poco transparentes. Esto es crítico en la práctica clínica, donde la explicabilidad es fundamental para la seguridad y la confianza en la toma de decisión.
4) Lo que dice la regulación brasileña
Desde el 26 de agosto de 2026, el uso de inteligencia artificial en la práctica médica en Brasil pasó a ser regulado por la Resolución CFM n.º 2.454/2026. Usted no necesita decorar los detalles, pero vale conocer los principios centrales, porque confirman — ahora también como norma — exactamente lo que ya veníamos reforzando en este e-book:
- La IA es apoyo a la decisión; la decisión clínica final siempre debe ser humana.
- La IA no puede comunicar diagnóstico, pronóstico o conducta directamente al paciente — eso sigue siendo papel del médico.
- El uso de IA en la atención debe quedar documentado en la historia clínica (herramienta utilizada, finalidad y la revisión humana de la sugerencia).
- El médico sigue siendo plenamente responsable por los actos practicados con apoyo de IA — la herramienta no comparte ni transfiere esa responsabilidad.
Como toda norma reciente, es posible que existan actualizaciones o regulaciones complementares después de la publicación de este material — vale consultar el texto vigente directamente en el sitio del CFM (cfm.org.br) antes de basar cualquier decisión de compliance en él.
Cautela extra: la necesidad de revisión humana
Jamais utilize el resultado de una IA directamente para la toma de decisión clínica sin revisión rigurosa. La herramienta puede servir como apoyo, pero la responsabilidad y el juicio final son siempre humanos (human-in-the-loop) — y, en Brasil, eso dejó de ser apenas buena práctica para volverse exigencia regulatoria.
Prompts avanzados para consulta
Esta sección funciona como un catálogo de consulta: técnicas de prompting más sofisticadas, cada una con un ejemplo genérico (listo para editar) y, en la mayoría de los casos, un segundo ejemplo ya aplicado a un contexto — clínico, jurídico o administrativo — para que usted vea el patrón en acción. No es preciso decorar los nombres en inglés; vuelva aquí siempre que necesite copiar y adaptar uno de esos modelos a su tarea del momento.
Prompt para descomposición de tareas complejas (para productividad)
Ejemplo[TASK DECOMPOSITION - REAL EXAMPLE]
My main task is: Prepare a 2025 departmental spending-analysis report for presentation to the executive board.
Please break this down into sequential subtasks, numbered from 1 to N.
For EACH subtask, provide:
- Subtask number and title
- Description of what needs to be done
- Success criterion
- Any prior dependency
- Estimated time
Additional context:
- We have data from three sources: SAP, internal spreadsheets, and department receipts
- The presentation is in 2 weeks
- Audience: 8 non-technical executives
- Expected format: 15-20 slides with the main chartsEjemplo editable
[TASK DECOMPOSITION]

My main task is: [DESCRIBE THE OVERALL TASK]

Please break it into sequential subtasks, numbered from 1 to N.

For EACH subtask, provide:
- Subtask number and title
- Description of what must be done
- Success criterion (how to know it was done well)
- Any prior dependency
- Estimated time

Then present a recommended execution timeline.
Cadena de Pensamiento (Chain of Thought)
Ejemplo editable:
[Chain of Thought - EDITABLE]
You are a [SPECIALIST IN WHAT?].
Analyze: [DESCRIBE THE CASE / PROBLEM]

Think step by step:
1. [WHAT IS THE FIRST LOGICAL STEP?]
2. [WHAT IS THE SECOND STEP?]
3. [WHAT IS THE THIRD STEP?]

Respond by detailing each step of your reasoning.
Ejemplo completo:
[Chain of Thought - FULL]
You are a project manager. Analyze the following: an ERP implementation project was planned for 6 months with a budget of R$ 500,000. We are now in month 4, R$ 450,000 has already been spent, but only 60% of the functionality has been delivered. The client is dissatisfied.

Think step by step:
1. Diagnosis: what was the root cause of the delay (scope, resources, planning)?
2. Impact analysis: how much extra time and cost will be required?
3. Strategy: what options exist (extension, scope reduction, larger team)?

Respond by detailing each stage.
Árbol de Pensamiento (Tree of Thought)
Ejemplo editable:
[Tree of Thought - EDITABLE]
Analice: [DESCRIBA UN ESCENARIO COMPLEJO CON MÚLTIPLES OPCIONES]

Elabore un árbol de pensamientos simulando múltiples escenarios:

Escenario 1: [PRIMERA OPCIÓN]
- Sub-consecuencia 1a: [...]
- Sub-consecuencia 1b: [...]
- Desenlace probable: [...]

Escenario 2: [SEGUNDA OPCIÓN]
- Sub-consecuencia 2a: [...]
- Sub-consecuencia 2b: [...]
- Desenlace probable: [...]

Escenario 3: [TERCERA OPCIÓN]
- Sub-consecuencia 3a: [...]
- Sub-consecuencia 3b: [...]
- Desenlace probable: [...]

Síntesis: ¿Qué escenario presenta mayor probabilidad de éxito?
Ejemplo completo:
[Tree of Thought - COMPLETO]
Una empresa necesita decidir sobre expansión internacional. Analice los tres escenarios principales:

Escenario 1: Mercado de Asia (alto riesgo, alto retorno)
- Inversión inicial: $10M
- Barreras regulatorias: altas
- Potencial de mercado: 500M de personas
- Desenlace probable: Retorno en 4-5 años si consigue entrada

Escenario 2: Mercado de América Latina (riesgo medio, retorno medio)
- Inversión inicial: $5M
- Barreras regulatorias: medias
- Potencial de mercado: 150M de personas
- Desenlace probable: Retorno en 2-3 años

Escenario 3: Mercado Europeo (bajo riesgo, bajo retorno)
- Inversión inicial: $3M
- Barreras regulatorias: altas
- Potencial de mercado: 100M de personas
- Desenlace probable: Retorno estable en 1-2 años

Síntesis: América Latina ofrece el mejor equilibrio riesgo-retorno para expansión en el corto plazo.
Cadena de Aprendizaje (Chain of Learning)
Ejemplo editable:
[Chain of Learning - Ejemplo editable]
Actuará como simulador interactivo para mi entrenamiento en [¿QUÉ DOMINIO?].

[Su papel]
1. Cree un escenario o problema inicial sobre [TEMA ESPECÍFICO]
2. No revele la solución de inmediato
3. Proporcione información neutra a medida que yo avance
4. Ajuste la dificultad según mi desempeño
5. Revise mi razonamiento y señale lagunas

[Formato de interacción]
- Yo presento mi análisis o solución
- Usted ofrece retroalimentación constructiva
- Iteramos hasta alcanzar dominio del tema

Estoy listo para comenzar. ¿Cuál es el dominio y el tema?
Ejemplo completo:
[Chain of Learning - Ejemplo completo]
Actuará como simulador interactivo para mi entrenamiento en Epidemiología Clínica.

[Su papel como profesor-simulador]
1. Cree un escenario realista de brote epidemiológico (por ejemplo: "Detectamos 15 casos de gastroenteritis en una guardería durante 3 días")
2. No revele de inmediato la etiología más probable
3. Proporcione datos cuando yo los solicite (síntomas, incubación, exposiciones, laboratorio)
4. Aumente la complejidad a medida que demuestre comprensión (por ejemplo: factores de confusión)
5. Revise mi razonamiento epidemiológico (¿fue adecuada mi hipótesis inicial?)

[Mi enfoque]
- Formularé hipótesis sobre la fuente y la vía de transmisión
- Solicitaré datos específicos para probar esas hipótesis
- Usted me dará feedback sobre la adecuación de la investigación

Estoy listo. Presente un escenario de brote.
Cadena de Verificación (Chain of Verification)
Técnica que reduce las alucinaciones al pedirle a la IA que genere preguntas de verificación y revise sus propias premisas antes de ofrecer la respuesta final.
[Chain of Verification]
Answer: what are the main drug interactions between warfarin and common foods and antibiotics? After answering, follow this verification protocol: 1. Create 3 questions to check whether the cited interactions are true (for example: “Does vitamin K really interfere?”). 2. Answer those questions independently. 3. Provide a revised and corrected final answer based on those checks.
Misma lógica aplicada a un contexto jurídico:
[Chain of Verification]
List 3 recent decisions from the Brazilian Superior Court of Justice (STJ) on hospital civil liability. Follow the CoVe protocol: 1. Generate questions to confirm case number and year. 2. Answer whether the cases exist and actually concern the topic. 3. Deliver only the confirmed cases.
Cadena de Debate (Chain of Debate)
Simula un debate entre múltiples perspectivas (personas) para explorar un tema complejo y llegar a una síntesis más equilibrada.
[Chain of Debate] Actuarás como dos médicos especialistas debatiendo internamente. Contexto: paciente anciano, frágil, con múltiples comorbilidades y diagnóstico reciente de cáncer avanzado. Tarea: simula un debate interno estructurado: el Especialista A defiende el tratamiento agresivo y el Especialista B defiende los cuidados paliativos tempranos. Cada uno debe presentar sus argumentos, refutar los del otro y reconocer limitaciones. Finaliza con una síntesis equilibrada.La técnica funciona igual fuera de la medicina — vea un ejemplo jurídico:
[Chain of Debate]
Simulate a discussion between a defense attorney, a prosecutor and a judge about the admissibility of WhatsApp evidence obtained without authorization in a corruption case. Debate “Fruit of the Poisonous Tree” versus “Public Interest.”
Autoconsistencia (Self-Consistency)
Genera múltiples razonamientos independientes para el mismo problema y verifica la coherencia entre ellos para formular una conclusión más robusta (gana la "mayoría").
[Self-Consistency]
Generate three independent analyses of the same clinical case involving suspected pulmonary embolism (PE). Produce three separate diagnostic reasoning paths. Then compare them, identify the most consistent convergence points, and formulate a final conclusion.
Otro contexto, mismo principio:
[Self-Consistency]
Generate three independent legal analyses of the same contractual case. Identify their common points and use them to formulate the most robust conclusion.
Autocrítica (Reflexion)
Obligatorio para tareas críticas: pide a la IA criticar su propia respuesta inicial y refinarla con base en esa autocrítica.
[Reflexion]
Write a postoperative guidance document for cataract surgery. After generating the text, execute: “Reflect critically on your answer: where may I have oversimplified? Which assumptions may be wrong? What additional information would change my conclusion?” After that reflection, refine your original answer.
Fuera de la medicina, el mismo principio vale para un parecer jurídico:
[Reflexion]
Reflect critically on the legal opinion you have just produced. Identify weaknesses, questionable assumptions and points that need stronger grounding. Revise the opinion after that analysis.
Encadeamento de Prompts (Prompt Chaining)
Rompe una tarea compleja en una secuencia de prompts donde la salida de uno sirve como entrada para el próximo.
[Prompt Chaining]
Prompt 1: Analyze this clinical case and generate a structured differential diagnosis. Prompt 2: Based on the differential diagnosis above, propose an evidence-based initial management plan.
Aplicando la misma lógica de encadeamiento a un caso jurídico:
[Prompt Chaining]
Prompt 1: Summarize the main legal risks in the presented case. Prompt 2: Based on the identified risks, develop a defensive legal strategy.
Conocimiento Generado (Generated Knowledge)
Solicita que la IA use lógica de programación o pseudo-código para estructurar razonamientos lógicos o matemáticos con mayor precisión.
[Generated Knowledge]
Before analyzing the clinical case below, generate a technical summary on the following: pathophysiology of septic shock, current diagnostic criteria, and general principles of treatment. Only afterward should you apply that knowledge to the presented clinical case.
Y en un contexto contractual:
[Generated Knowledge]
Before analyzing the case, generate a technical summary on the following: principles of contractual good faith and legal grounds for rescission. Then apply that knowledge to the concrete case.
De lo más simple a lo más complejo (Least-to-Most)
Estrategia educativa y de resolución de problemas que pide explicar el concepto de lo básico a lo avanzado, o resolver primero subproblemas simples antes de enfrentar el problema complejo.
[Least-to-Most]
First explain, in simple language, what heart failure is. Then: 1. Explain the pathophysiological mechanisms. 2. Differentiate HF with preserved versus reduced ejection fraction. 3. Relate that distinction to therapeutic choice.
Aplicando la misma lógica a una due diligence:
[Least-to-Most]
To conduct due diligence on a startup, first identify the 4 critical risk areas. Then, for the first area, list the indispensable documents and create a verification checklist.
Estímulo Direcional (Directional Stimulus)
Proporciona "pistas" o señales específicas para orientar el razonamiento de la IA hacia una prioridad deseada (por ejemplo, priorizar la seguridad).
[Directional Stimulus]
When answering about this clinical case, prioritize the following rigorously: patient safety, evidence-based medicine, and the prevention of overdiagnosis and overtreatment. [Describe the clinical case here].
Y en un contexto de litigio:
[Directional Stimulus]
When answering about this dispute, prioritize the following: minimization of legal risk, conservative interpretation of the law, and protection of the client’s assets. [Describe the case.]
Razonamiento Asistido por Código (Program-Aided Language)
Solicita que la IA use lógica de programación o pseudo-código para estructurar razonamientos lógicos o matemáticos con mayor precisión.
[Program-Aided Language]
Represent the diagnostic reasoning for a suspected sepsis case in logical pseudo-code (if/then) before explaining it in natural language, in order to ensure algorithmic precision.
Otro uso típico, ahora para un cálculo financiero:
[Program-Aided Language]
Calculate the value of a R$ 50,000 debt due on 10/01/2023, with 1% interest and IPCA inflation of 4.5%. Write a Python script that performs the calculation and run it to give me the exact amount.
ReAct (Razonamiento + Acción)
Alterna pensamiento (razonamiento) y acción (búsqueda de información o uso de herramientas) en un ciclo continuo para resolver problemas dinámicos.
[ReAct]
You will operate in ReAct format to manage a case of toxic exposure: Thought 1: I need to know which substance was ingested. Action 1: Ask the user. Thought 2: Based on the response, I should check the antidote. Action 2: Provide the dose. Continue the cycle until stabilization.
Y en un contexto jurídico:
[ReAct]
Alternate between legal reasoning and action: Thought: What does this notice mean? Action: Which document should be reviewed? Thought: What are the implications? Action: What response is recommended? Continue until a final strategy is reached.
¿Qué son los harness?
Si usted ya reparó que "el mismo ChatGPT" se comporta de formas muy diferentes según onde lo use. La lógica es más o menos la siguiente: GPT es el modelo y es colocado en varios contextos diferentes: vía página de internet, usted accede al chatGPT; en el computador, para generar código, usted usa el codex — el modelo es el mismo, pero las herramientas a las que él tiene acceso y las instrucciones básicas que dicen lo que puede o no hacer son diferentes. Ese ambiente alrededor del modelo es lo que llamamos harness.
La palabra viene del arnés (y del cinturón de seguridad)
Harness, en inglés, es el arnés de un caballo, la pechera de un perro, el cinturón de seguridad de quien escala (y otros ejemplos, sin prejuicios). Esa estructura que se viste alrededor de la persona define el contexto del trabajo de ella, su seguridad, con cuáles herramientas va a trabajar... La figura es autoexplicativa
En la inteligencia artificial, el harness es exactamente eso: la capa de software que envuelve el modelo y le da herramientas, memoria, permisos, validación y la capacidad de agir. Es la infraestructura que transforma "un previsor de texto" (el modelo) en "un asistente que hace diferentes cosas" (de acuerdo con el harness).
El modelo solo hace muy poco
Vale rescatar lo que vimos en la sección Basic mechanics: un modelo de lenguaje (LLM), aislado, hace una única cosa — recibe un texto y devuelve la continuación más probable, token a token. Solo, el modelo no navega por internet, no ejecuta código, no abre tus archivos, no recuerda la conversación de ayer y no realiza ninguna acción en el mundo. Solo genera texto.
Todo aquello que parece "la IA haciendo" — investigar, leer un PDF, rodar un cálculo, generar una planilla, citar la fuente exacta, recordar sus preferencias — es el harness trabajando alrededor del modelo.
Cómo funciona el harness, en la práctica
Cuando usted envía una tarea, el harness ejecuta más o menos este ciclo:
- Recibe la tarea y monta el contexto (junta su pedido, instrucciones fijas, memoria relevante y, si fuera el caso, trechos de documentos que él fue buscar para usted).
- Lo envía al modelo y lee la respuesta.
- Si el modelo "pide" una herramienta (buscar en la web, ejecutar un código, leer un archivo, consultar una API), es el harness quien de facto ejecuta esa acción y devuelve el resultado al modelo.
- Repite el ciclo cuántas veces sean necesarias — razonar, agir, observar el resultado, razonar de nuevo — hasta que la tarea quede lista.
- Aplica las travas (guardrails): lo que está permitido, lo que exige su confirmación, lo que necesita ser validado.
- Entrega el resultado — muchas veces con registro de los pasos y de las fuentes (observabilidad).
La analogía del motor y del vehículo
Es la misma lógica de las bicicletas y los carros que usé en la sección Modelos de IA, ahora un andar arriba. Referencia de viejo: con un motor de Fusca, usted puede hacer tanto el Herbie cuanto un ultraleve. El modelo es el motor y la carcasa — lo que está alrededor — es el harness. En ese ejemplo bizarro es evidente que el harness da funciones y características muy diferentes al modelo.
Por eso "¿cuál es el mejor modelo?" es una pregunta incompleta. En la práctica, usted casi nunca usa un modelo puro: usted usa un modelo + harness. Cuando usted compara el ChatGPT con el Gemini Notebook, o el Claude en el sitio con el Claude dentro de un editor de código, buena parte de la diferencia que usted siente es el harness, no el modelo.
De herramienta a agente
Cuando el harness da al modelo autonomía para planear, agir en ciclos y decidir los propios pasos — y, a veces, accionar "subagentes" especializados (uno para código, uno para imágenes, uno para investigación) —, es de eso que las personas hablan cuando dicen agente de IA o IA agéntica. Un agente, de forma simple, es modelo + harness con libertad para agir.
Ejemplos de harnesses que usted probablemente ya usó
| Herramienta | Lo que el harness añade al modelo |
|---|---|
| App común (ChatGPT, Gemini, Claude) | Harness "leve": histórico de la conversa, memoria de preferencias, algunos utilitarios (búsqueda rápida, upload de archivo, ejecución puntual de código). |
| Deep Research | Harness "pesado" de investigación: crea un plan, hace decenas de búsquedas, cruza fuentes contradictorias y sintetiza un informe — todo en ciclos. |
| Gemini Notebook | harness de grounding (RAG): obliga al modelo a responder somente a partir de las fuentes que usted añadió, con cita del trecho de origen. La reducción de alucinación viene del harness, no del modelo. |
| Ambientes de programación agéntica (Claude Code, Codex, ZCode) | Harness con acceso al terminal y a los archivos del proyecto: edita código, roda los tests, lee el error, corrige y repite hasta pasar. |
| IA embebida en un sistema clínico | Harness institucional: conecta al prontuario, restringe lo que puede ser hecho, registra cada uso y mantiene al médico como decisor (human-in-the-loop). |
Resumiendo: el modelo es lo que piensa; el harness es lo que permite pensar con herramientas, agir con límites y prestar cuentas de lo que fue hecho. Sin harness, el modelo no opera en el mundo real — y es el harness que, en la práctica, usted contrata, configura y fiscaliza.
Contactos
IA e Medicina