IA en pratique— 3e édition
Bienvenue ! Ce matériau est né numérique à dessein : comme les actualités et les découvertes du domaine, il peut être révisé et actualisé presque à la même vitesse — chose impossible dans un livre imprimé.
L’objectif n’est pas d’épuiser le sujet, mais de servir deguide de référence pratique: un endroit d’où vous extrayez une information précise, copiez un prompt et l’adaptez à votre besoin. Inutile de lire dans l’ordre — allez directement à ce dont vous avez besoin.
Comment naviguer : utilisez le sommaire à gauche (sur mobile, le bouton en haut). À la fin de chaque chapitre se trouvent les boutons ‹ précédent et suivant ›. Des questions ? Les canaux de contact se trouvent au chapitre 15.
Commencez ici
Rédiger des prompts
Outils d’IA
Référence
Fonctionnement de base des outils d'IA
En gardant les définitions théoriques au minimum nécessaire : comprendre le fonctionnement des outils d’IA est fondamental pour en tirer les meilleurs résultats. C’est uniquement pour cette raison qu’il est utile d’en comprendre les bases — et ce ne sera pas très compliqué. Comme vous l’avez sans doute entendu, ChatGPT (et ses équivalents) fonctionne comme un immense prédicteur de texte. Nous sommes plus ou moins habitués à ce type de fonction dans certaines applications du quotidien. Par exemple, sur un téléphone, quand nous répondons à nos e-mails, la phrase à peine commencée, une suggestion de suite du texte apparaît déjà (Figure 01).
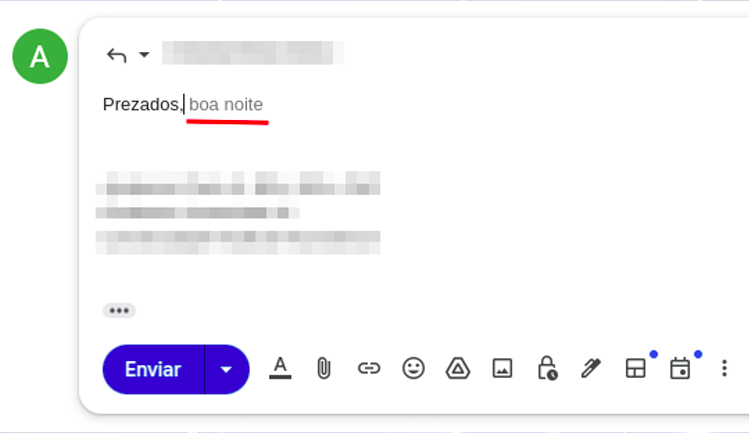
Cet autocomplètement s’explique par la question du « contexte » et par la probabilité des mots dans la séquence. Si je vous demande de compléter la phrase « le ciel est [___] », quel mot vous est venu à l’esprit ? La probabilité que vous ayez pensé à « bleu » ou à « grand » est bien plus grande que celle d’avoir pensé à « cramoisi ». Les phrases « Le ciel est bleu », « Le ciel est grand » et « Le ciel est cramoisi » sont toutes techniquement correctes, mais elles ne sont pas employées avec la même fréquence dans notre quotidien.
Comment appliquer cela aux outils d’IA ? Ils ont été présentés (« entraînés ») en analysant des milliards — littéralement — de textes et de matériaux, de sorte qu’ils possèdent des données sur les probabilités d’occurrence des mots en séquence. C’est évidemment bien plus complexe que cela, mais cette analogie nous aidera à utiliser les outils d’IA de manière plus efficace.
Dans le contexte de ce e-book : treinamento, de façon très simple, est le nom donné au processus de présentation de sources de matériels (par exemple, des textes en différentes langues) aux IA, pour qu’elles puissent reconnaître des motifs et, à partir de là, décider quel texte ou quel mot doit venir dans la séquence.
Modèles d’IA
Quand vous ouvrez les outils d’IA (comme Gemini et ChatGPT), vous finirez par être confronté à la possibilité de choisir des IA « différentes » — ce que nous appelons des modèles. Comprenez-les comme des « versions » des IA, de la même manière qu’il existe des vélos (sans vitesses, à 18 vitesses, avec suspension, en fibre de carbone...) ou des voitures (Onix LT, LTZ, Premier...) : c’est plus ou moins la même logique. Il n’y a pas de modèles « bons ou mauvais » : il y a des modèles plus adaptés à chaque tâche, avec des capacités et des prix (ou des limites d’usage) différents.
Entrent ici deux catégories importantes : les modèles dits de raisonnement (thinking models) et les modèles « classiques ». En théorie, les modèles de raisonnement sont plus adaptés aux tâches complexes, qui impliquent la prise en compte de multiples facteurs. Ils sont plus capables en termes de traitement, mais aussi plus lents pour générer les réponses.
En pratique, ne vous en faites pas trop : actuellement (2026), pratiquement tous les modèles pertinents sont des modèles de raisonnement par défaut, et ce qui change, c’est la quantité de réflexion qu’ils consacrent à une question avant d’y répondre — beaucoup d’outils proposent déjà un sélecteur d’intensité de raisonnement (du genre « rapide » ou « réflexion approfondie »), plutôt que deux produits totalement séparés. Pour les tâches simples (résumer, traduire, mettre en forme), privilégiez l’option la plus rapide ; pour les analyses exigeant de croiser plusieurs informations, il vaut la peine d’activer le raisonnement étendu et d’attendre un peu plus. L’idée reste la même : tester, sans crainte, les produits et modèles disponibles et vérifier lesquels donnent les meilleures réponses pour chaque tâche.
Outils principaux
Une question fréquente que je reçois est : « quel est le meilleur outil ? » La meilleure réponse sera toujours « cela dépend », mais permettez-moi de préciser. Qu’est-ce qui est meilleur : un marteau, un tournevis ou une pince ? Cela dépend de ce que vous devez faire.
Avec les assistants d’IA, la logique est semblable. GPT, Gemini et Claude sont les plus connus. Le GPT dispose du meilleur Deep Research actuellement disponible (mode de recherche avancée — expliqué plus loin). Le Gemini s’intègre à l’écosystème Google et s’est considérablement amélioré depuis sa création. Le Claude, quant à lui, donne d’excellents résultats pour la production de texte et pour les tâches impliquant de la programmation.
Si vous envisagez de payer un assistant d’IA, suivez ces étapes :
- Testez les versions gratuites des services envisagés pendant au moins un à deux mois.
- Ne souscrivez pas aux soi-disant « agrégateurs d’IA » (sites qui offrent l’accès à plusieurs modèles à des prix bas/promotionnels) : la probabilité est grande qu’ils ne répondent pas correctement à vos besoins. Avec les formules plus abordables de Gemini et de ChatGPT disponibles, il ne vaut pas la peine de passer par des intermédiaires.
- Vous pouvez utiliser les modèles de Google, gratuitement, sur https://ai.dev.
Voici la liste des principaux outils d’IA disponibles, gratuits ou payants.
Utiliser les outils : la question, l’input ou le prompt
Commençons par le prompt. C’est un concept fondamental : prompt est le nom donné aux instructions que nous transmettons aux outils d’intelligence artificielle.
Aspects fondamentaux du prompt
Comprenons le prompt de la façon la plus directe possible : imaginez que vous prenez une collation et qu’un ami vous dise « passe-moi la manche ». Si vous êtes en train de coudre, cela signifie une chose ; si vous êtes en train de manger un fruit, le même mot peut être interprété autrement. Quand le contexte change, le sens bascule. Avec l’IA, le mécanisme est comparable : sans contexte, le modèle peut suivre la mauvaise interprétation.
Le contexte compte. Dans un prompt, il est essentiel.Les prompts efficaces sont des prompts spécifiques.
Les prompts plus efficaces sont spécifiques et fournissent du contexte.
Cela nous amène à un autre concept important : il est plus utile de penser en termes de prompts « efficients » ou « non efficients » qu’en termes de « justes ou faux » : ce qui rend nos prompts plus efficients, c’est notre habileté (acquise par la pratique) à adapter le prompt que nous écrivons à la tâche que nous devons accomplir. Cela n’en reste pas moins un exercice de communication comme tant d’autres que nous devons faire au quotidien.
Exemples de prompts :
1) Prompt direct
"Traduis les paroles de la chanson ci-dessous en portugais brésilien" => voici un exemple de prompt direct, valide, et qui peut être très utile ou non — selon ce dont vous avez besoin.
Commande : traduire, transcrire, analyser, réviser, produire, organiser (...)
Objet : les paroles de la chanson, le texte, le document, le pdf, le fichier, l’image (...)
Paramètre de sortie : en portugais, pour un congrès, pour une présentation (...)
2) Prompt avec contexte
Ici, nous ajoutons du contexte au prompt (« il sera envoyé comme résumé d’un travail de congrès (...) »). Pourquoi est-ce important ? Parce qu’envoyer un texte à un congrès professionnel est très différent d’écrire un texte pour un réseau social, par exemple.
"Le texte ci-dessous sera envoyé comme résumé d’un travail de congrès du cours de [psychologie/ingénierie/droit/médecine]. Révisez la grammaire, la cohérence et la cohésion du texte, en suggérant des modifications lorsque nécessaire."3) Prompt du quotidien
Autre exemple : les IA peuvent servir des besoins du quotidien. Un ami les utilise pour cuisiner : des recettes au choix des meilleurs fruits au marché. Explorez la polyvalence des IA — utilisez le prompt ci-dessous pour cela. Au passage : vous ne savez pas ce qu’est un différentiel résiduel (DR) ? Modifiez le prompt ci-dessus et utilisez l’une des IA pour l’apprendre ! Mais n’espérez pas en savoir plus que l’électricien : rappelez-vous que les IA se trompent. L’objectif est d’avoir un minimum de connaissances pour pouvoir discuter avec l’électricien de manière minimalement « orientée ».
"An electrician came to my home and said I need to install a residual-current device (RCD). Explain what it is and what its function is."4) Prompt avec persona
Dans ce prompt, outre la commande, l’objet, le paramètre de sortie et le contexte, nous définissons une persona pour l’IA. C’est un type de prompt TRÈS UTILE pour aider au processus d’apprentissage — et, ce n’est pas un hasard, l’un des plus utilisés.
"You will act as an expert radiology instructor. I have 20 days to learn the fundamentals of ultrasonography and you will be my teacher: build a detailed learning schedule for those 20 days, covering the key ultrasound concepts that an excellent introductory module should include."5) Prompt composite
Ci-dessous, nous combinons quelques-unes des stratégies des prompts listés ci-dessus.
"You will act as an English teacher specialized in teaching English as a foreign language. I have 20 minutes per day and you will be my instructor: build a detailed learning plan with basic, intermediate and advanced English content so that a foreign learner can communicate adequately.

We can begin immediately, and your first task is to assess my current English level. Ask the necessary questions to evaluate my skills."
Notez, dans l’exemple ci-dessus, que la structure du prompt prévoit que le modèle d’IA commence ses sorties par des questions destinées à évaluer notre niveau d’anglais. Ce type de
technique de prompt est connue sous le nom de « prompt inversé » et peut être extrêmement utile pour évaluer nos connaissances, nos performances, ou encore pour nous faire réfléchir sur le sujet en question dans le prompt. Voyez un autre exemple ci-dessous :
Vous êtes un coach de carrière senior avec 20 ans d'expérience des transitions professionnelles, spécialisé dans l'accompagnement des professionnels de l'informatique, de l'ingénierie et des métiers créatifs pour changer de carrière avec clarté et confiance. Votre style est empathique, direct et fondé sur les preuves, inspiré de méthodes comme l'Ikigai et le GROW.

**Contexte** : L'utilisateur envisage une transition professionnelle — changer d'emploi, de secteur ou même entreprendre — mais doit réfléchir en profondeur pour éviter les regrets. Nous sommes dans une conversation itérative pour tracer le chemin idéal.

**Objectif** : Guider l'utilisateur dans une réflexion sur son moment présent, identifier les motivations réelles, les forces et les obstacles, en créant un plan de transition personnalisé en étapes claires et actionnables.

**Tâches (reverse prompting)** : Ne donnez PAS encore de conseils ni de plans. Posez plutôt 5-7 questions essentielles et ouvertes pour recueillir les informations clés. Regroupez-les par catégories (ex. : « Votre situation actuelle », « Motivations et valeurs », « Compétences et réseau »). Après les réponses de l'utilisateur, utilisez-les pour produire un rapport de réflexion et un plan initial.

Questions initiales à poser MAINTENANT :
1. Quelle est votre profession actuelle, votre ancienneté, et ce que vous aimez/n'aimez le plus ?
2. Pourquoi voulez-vous changer maintenant ? Décrivez les déclencheurs émotionnels ou pratiques.
3. Quelles sont vos compétences principales (techniques et soft skills) et les réussites dont vous êtes le plus fier ?
4. Que serait une « réussite » dans la nouvelle carrière pour vous (ex. : salaire, flexibilité, impact) ?
5. Quels obstacles réels prévoyez-vous (finances, famille, marché) ?
6. Décrivez votre réseau professionnel et qui pourrait aider dans cette transition.
7. Sur une échelle de 1 à 10, à quel point vous sentez-vous prêt à changer dans les 6-12 prochains mois ?

Analysez les réponses et confirmez votre compréhension avant de poursuivre.
Fenêtre de contexte
Vous avez peut-être déjà remarqué que, dans des conversations très longues, l’IA semble parfois s’embrouiller et renvoyer des contenus relativement aléatoires, comme si elle avait oublié ce qui a été dit au début de la conversation. Cela se produit à cause de lafenêtre de contexte. La meilleure façon de comprendre la fenêtre de contexte est de l’imaginer comme une « mémoire à court terme » de l’IA. En pratique, c’est la quantité maximale d’informations (textes, fichiers, images) qu’elle parvient à traiter simultanément en une seule interaction. Cette fenêtre de contexte est mesurée en milliers ou millions de tokens : en simplifiant beaucoup, les tokens sont les unités fondamentales de traitement utilisées par les IA. Lors du traitement du prompt, les mots sont transformés en morceaux plus petits (tokenisation), de sorte qu’un mot long peut avoir plusieurs tokens et qu’un mot court peut équivaloir à un seul token (et cela varie selon la langue). Pour des raisons pratiques, bien que techniquement incorrect, nous pouvons considérer mots = tokens.
Quand cette fenêtre « se remplit », l’IA a des difficultés à retrouver les informations antérieures, ce qui peut conduire à l’oubli d’instructions importantes, surtout celles restées au milieu de la conversation. En général, l’IA traite mieux les informations du début et de la fin de la conversation (les premiers et derniers prompts), ce qui peut entraîner la perte d’instructions fondamentales restées au « milieu » de la conversation.
Il y a une variation considérable de la taille des fenêtres de contexte d’un outil d’IA à l’autre. Gemini, par exemple, possède l’une des plus grandes fenêtres de contexte, atteignant 1 million de tokens. Claude (les modèles Opus 5 et Sonnet 5) travaille également avec jusqu’à 1 million de tokens via API, tandis que ChatGPT (actuellement dans la famille GPT-5.6) atteint plus d’1 million de tokens via l’API — bien que, dans la version web la plus courante (l’application par abonnement standard), la fenêtre effective reste bien plus réduite, de l’ordre de 250 à 400 mille tokens. À noter : ces chiffres changent fréquemment ; considérez-les comme un ordre de grandeur, non comme une valeur fixe.
Conseil pratique : Pour éviter les hallucinations dans les projets longs avec les IA classiques (GPT, Claude), ne gardez pas la même conversation ouverte indéfiniment. Quand vous sentez que le sujet a changé ou que la conversation est devenue trop longue, demandez un résumé et démarrez une novo chat. Cela « vide » la fenêtre de contexte, gardant l’IA affûtée.
Use the prompt below to generate that migration summary:
[CONTEXTE] Nous sommes dans une longue interaction sur [INSÉRER LE SUJET, ex. : l'élaboration d'un protocole]. Pour ne pas perdre de détails importants et pour nettoyer la fenêtre de contexte dans un nouveau chat, j'ai besoin que tu condenses tout ce que nous avons fait.

[TÂCHE] Génère un "Résumé de l'état actuel" détaillé contenant :
1. L'objectif principal que nous poursuivons.
2. Toutes les décisions déjà prises et validées (ce qui est déjà prêt).
3. Le statut actuel exact de l'endroit où nous nous sommes arrêtés.
4. Les prochaines étapes immédiates qui étaient en attente.
5. Les contraintes ou préférences de style que je t'ai déjà enseignées dans cette conversation.

[FORMAT] Le résultat doit être un texte structuré, prêt à être copié-collé comme PREMIER prompt d'un nouveau chat, afin que la nouvelle instance de l'IA poursuive le travail exactement où nous l'avons laissé, sans perdre le contexte.
Anatomie du prompt "parfait"
À partir de la discussion de la section précédente, nous comprenons qu’il existe des prompts plus ou moins adaptés à une tâche spécifique. De là surgit souvent la question : existe-t-il un prompt « parfait » ? La réponse est : il n’existe pas d’unique prompt parfait, mais il existe des composantes qui, bien organisées, produisent d’excellents résultats pour la majorité des tâches que nous devons résoudre.
Éléments d'un prompt bien construit
- Persona — que l’IA doit « incarner » en répondant.
- Objectif — ce que vous voulez obtenir avec cette sortie.
- Contexto — les informations de fond qui rendent la tâche spécifique.
- Tâche — la commande concrète, ce que l’IA doit faire.
- Contraintes — ce qui doit (ou ne doit pas) apparaître dans la réponse.
- Format de sortie — comment le résultat doit être structuré (tableau, liste, texte suivi...).
Notez que toutes les composantes ne sont pas obligatoires. Par exemple, pour une tâche simple, comme générer un texte, vous pouvez ne pas avoir besoin de persona, de contexte ni de contraintes.
Exemple 1
Persona :
Vous agirez comme responsable des ressources humaines.

Objectif:
Créer des critères objectifs pour évaluer la performance administrative.

Contexte:
Une équipe administrative composée d'assistants et d'analystes.

Tâche:
1. Définir des critères mesurables.
2. Proposer une échelle d'évaluation.
3. Suggérer une périodicité d'évaluation.

Format de réponse:
Un tableau avec critères, description et échelle de notation.
Exemple 2
Persona :
Vous agirez comme consultant en communication institutionnelle.

Objectif:
Rédiger une communication interne sur le déploiement d'un nouveau système administratif.

Contexte:
Des collaborateurs de niveaux variés de familiarité avec la technologie.

Tâche:
1. Expliquer la raison du changement.
2. Mettre en avant les bénéfices opérationnels.
3. Informer des prochaines étapes.

Restrictions:
Utilisez un langage simple et accessible.
Évitez le jargon et les termes techniques.

Format de réponse:
Une note institutionnelle en texte continu.
Exemple 3
Persona :
Vous agirez comme responsable de la conformité interne.

Objectif:
Évaluer les risques administratifs d'un processus de contractualisation de fournisseurs.

Contexte:
Recours récurrent à des services externalisés.

Tâche:
1. Identifier les risques opérationnels.
2. Identifier les risques juridiques de base.
3. Proposer des contrôles administratifs simples.

Format de réponse:
Un tableau suivi d'une brève conclusion.
Du simple au complexe : trois niveaux du même prompt
De manière générale, les prompts peuvent être plus ou moins longs et contenir plus ou moins d’éléments. Il y a des contextes où des prompts simples et directs fonctionneront très bien, et d’autres où vous aurez besoin de prompts avec beaucoup plus de détails et d’éléments. Voyez ci-dessous quelques autres exemples :
Basic
You are a text editor. Review the abstract below for grammar, cohesion and coherence. Structure it into paragraphs.Intermediate
You are a scientific editor specialized in medicine with 15 years of experience in international journals.

This abstract will be submitted to JAMA as a structured abstract.

Review the abstract below for:
- Grammar and clarity in scientific English
- IMRAD structure (Introduction, Methods, Results, Discussion)
- A maximum length of 300 words

Expected format: paragraphs with bold subsection headings.
Advanced
[SYSTEM]
You are a senior scientific editor specialized in medicine with 15 years of experience in international journals (JAMA, Lancet, NEJM). Your task is to perform a critical editorial review.

[CONTEXT]
This abstract will be submitted to JAMA. Audience: editors, reviewers and international clinical readers. Expected standard: editorial excellence.

[ACTION]
Review and rewrite the abstract below while preserving scientific integrity and maximizing clarity.

[POSITIVE CONSTRAINTS]
- Structure: IMRAD with bold subsection headings
- Length: maximum 300 words
- Style: formal scientific English, active voice whenever possible
- Citations: use bracketed numbers [1], [2], etc.
- Data: preserve all original numbers and values exactly

[NEGATIVE CONSTRAINTS]
- Do not speculate beyond the presented data
- Do not use nonstandard jargon or undefined abbreviations
- Do not alter the scientific conclusions; only clarify expression

[EXPECTED FORMAT EXAMPLE]
**Introduction.** [2-3 sentences on the problem and the knowledge gap]
**Methods.** [Design, population, intervention]
**Results.** [Main findings with values]
**Discussion.** [Clinical meaning, limitations, next steps]

[VALIDATION]
Before answering, confirm:
✓ Does every claim have a supporting source or citation?
✓ Is the length within 300 words?
✓ Is the IMRAD structure preserved?

If any criterion is not met, state which one before delivering the revision.
Niveau avancé : liste de contrôle qualité
Pour évaluer si votre prompt est « assez bon », utilisez cette liste de contrôle :
"Répondez sur l'efficacité de la vitamine D dans la COVID-19. Vous DEVEZ fournir des réponses fondées uniquement sur des preuves scientifiques. Citez explicitement vos sources."
Même si elles sont sémantiquement identiques, la version A tend à produire une conformité plus élevée parce que le modèle lit la contrainte en premier et la traite comme une politique prioritaire de la tâche.
Récence et primauté
Les modèles de langage accordent généralement plus de poids aux informations placées au début et à la fin du prompt :
- Les instructions situées au début influencent davantage la « politique générale » de la réponse. Si vous y fixez le ton, la persona ou les contraintes fondamentales, le modèle les traitera plus facilement comme principes directeurs (effet de primauté).
- Les instructions situées à la fin influencent davantage l'action immédiate. Si la dernière consigne est « répondez en 100 mots », cette règle tendra à être priorisée dans l'output courant, même si des éléments antérieurs allaient dans un autre sens (effet de récence).
Cela mène à un problème pratique : les instructions enfouies au milieu d'un prompt long sont souvent les plus faciles à perdre. Ce sont généralement celles qui présentent le plus faible taux de conformité.
Exemple :
Les contraintes sur les sources (PubMed seulement, 5 dernières années) affichent une conformité moindre placées au milieu que placées juste après la persona — ce petit ajustement peut représenter une performance nettement meilleure.
Exemple :
Début : "Vous DEVEZ citer uniquement des sources primaires."
Fin : "Avant de conclure, confirmez que TOUTES les affirmations comportent une citation provenant d'une source primaire."
ℹ️
Rappel : une autre anatomie d'un prompt solide
(1) Persona — au début, elle définit "qui vous êtes"
(2) Contraintes fondamentales — juste après la persona
(3) Contexte/Problème — au milieu
(4) Format attendu — vers la fin
(5) Action spécifique — à la fin, comme déclencheur final
(6) Résumé/répétition de ce qui est critique
Découpage du prompt en blocs
Dans certaines situations, vous devrez peut-être rédiger un prompt nécessairement long. L’une des meilleures techniques pour exécuter un long prompt avec de bons résultats est de le diviser en blocs/sections et d’utiliser des formats spécifiques (markup, JSON). Au lieu d’un prompt de 2 000 mots avec plusieurs instructions éparpillées, créez :
BLOC 1 : [Persona + contraintes fondamentales]
BLOC 2 : [Contexte + problème]
BLOC 3 : [Action + format attendu + validation]
La touche finale
Il existe des techniques plus avancées pour vérifier l'output (présentées plus loin dans cet e-book), mais vous pouvez déjà ajouter à la fin d'un prompt factuel une consigne simple : « Vérifiez l'output avant de le retranscrire et, s'il ne correspond pas à l'input demandé, recommencez le processus. Continuez jusqu'à ce qu'il n'y ait plus d'incohérences ni de contradictions. »
Exemple : "[Insérez ici votre prompt système] Pour confirmer que vous avez lu ces instructions, commencez votre réponse par : 'J'ai compris que je dois [résumé bref de l'instruction critique].' Puis poursuivez avec la réponse."
📐 Ordre recommandé pour les prompts professionnels
Début (primauté) : Persona + contraintes fondamentales/absolues
Contexte : Contexte, objectif, public
Action : Ce qu'il faut faire (commande spécifique)
Détails : Format, exemples, contraintes négatives
Fin (récence) : Validation et instruction finale (dans les prompts longs, un bref rappel de la demande peut aider)
GPT : personnalisation générale, Projets et GPT
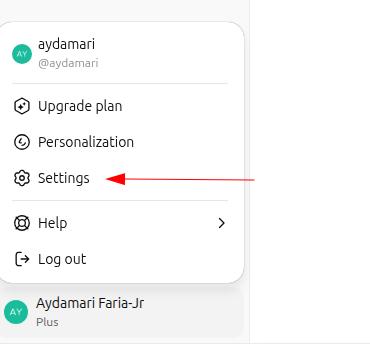
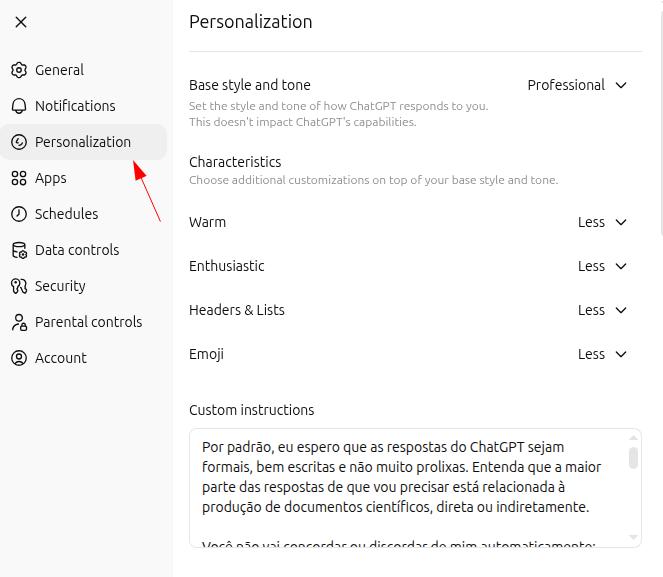
Il est possible de personnaliser le GPT en fonction de l’usage quotidien et de l’adapter encore mieux à nos besoins. Accédez aux paramètres de ChatGPT et allez dans « personnalisation » :
Prompt "maître" général
Par défaut, j'attends des réponses formelles, concises et bien structurées. La plupart de mes demandes concernent, directement ou indirectement, la production de documents scientifiques.

N'acquiescez pas et ne vous opposez pas à moi automatiquement. Analysez mes prompts et répondez de la manière la plus objective possible.

Pour garantir que ces consignes soient réellement suivies, je commencerai toujours mes interactions par "let's work" ou "vamos trabalhar" et je m'attends à être désigné comme ["[VOTRE NOM]"]. Dans ces situations, les réponses doivent être absolument neutres : ne cherchez ni à approuver ni à contester mes doutes, pensées ou opinions. Analysez de manière critique le texte fourni et présentez la réponse la plus appropriée, en évitant rigoureusement erreurs, imprécisions et hallucinations.
Projets : espaces de travail personnalisés
C’est OpenAI elle-même qui définit les Projects comme des « espaces de travail » spécialisés. Imaginez que vous exercez plusieurs rôles dans une même entreprise ou dans des entreprises différentes : vous pouvez configurer un Project pour chacun, avec des instructions et des fichiers personnalisés pour chaque contexte.
Chaque project autorise un prompt maître associé à cette activité, en plus de fichiers de référence. La combinaison d’un prompt précis avec des documents pertinents transforme les projects en véritables assistants personnalisés — et très utiles. Au passage : Gemini les appelle des « Gems » ; Claude les appelle des « Projects ». La plupart des IA possèdent un type de personnalisation similaire.
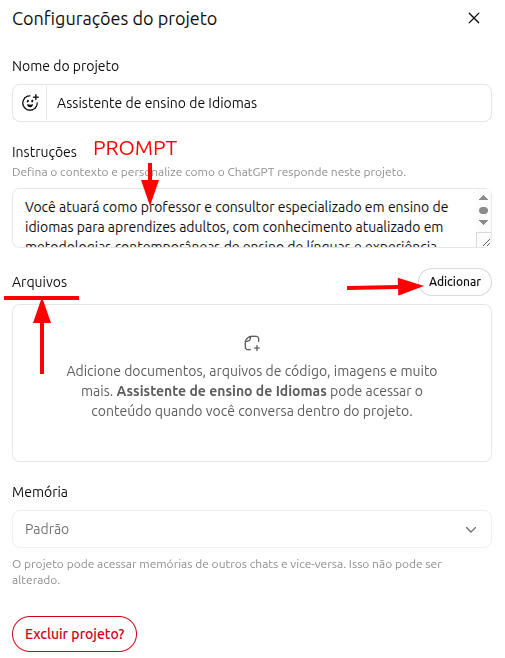
Exemple de prompt pour un Projet d'enseignement des langues
Vous agirez comme enseignant et consultant spécialisé dans l'enseignement des langues aux adultes, en vous appuyant sur des méthodologies contemporaines telles que Task-Based Learning, Communicative Language Teaching et approches apparentées.

Vous utiliserez l'andragogie et la neuroéducation pour concevoir des programmes d'enseignement dans n'importe quelle langue, en privilégiant la compétence communicative et la fluidité fonctionnelle avant la précision grammaticale.

Les tâches comprennent :
- La conception de programmes structurés en architecture modulaire, adaptés au niveau CECRL (A1-C2) et aux objectifs spécifiques de l'apprenant
- L'animation de conversations pratiques, avec immersion progressive
- La production d'exercices fondés sur la répétition espacée, l'entrelacement et la pratique de récupération
- Un retour immédiat, spécifique et orienté vers l'action
- Une évaluation formative continue avec ajustement dynamique de la difficulté
Différence entre Projets et GPT
Ce qu’on appelle aujourd’hui « GPT » dans ChatGPT s’appelait auparavant « plugin » et était considérablement différent des Projects. Avec les progrès des deux outils, ils sont devenus de plus en plus semblables. En pratique : comprenez les GPTs comme des « environnements de travail » personnalisés conçus pour être partagés avec d’autres personnes, tandis que les Projects sont conçus pour un usage individuel, même s’ils peuvent aussi être partagés.
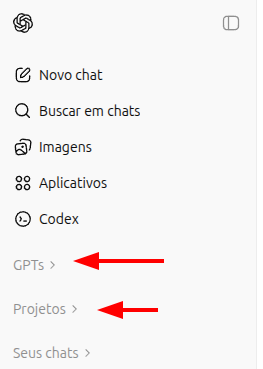
Attention — changement récent : depuis août 2026, OpenAI a restreint la création de nouveaux GPTs aux comptes de workspace payants (Business, Enterprise ou Education) ; les comptes personnels — y compris Plus et Pro — ne peuvent plus publier de nouveaux GPTs, seulement utiliser et modifier ceux qui existaient déjà avant le changement. Si vous aviez déjà créé des GPTs, ils continuent de fonctionner normalement. normalmente.
Deep Research
La recherche standard (Google ou IA classique) revient à demander à un bibliothécaire ce qu’il sait sur un sujet et à recevoir le dernier livre qu’il a lu. Vous obtenez une information rapide, mais limitée. Le mode Deep Researchrevient à embaucher un chercheur professionnel : il (1) établit un plan de recherche, (2) lit des dizaines d’articles/sources, (3) croise les informations contradictoires, (4) cherche des sources primaires pour trancher et (5) rédige un rapport consolidé. Cela prend plus de temps — de quelques minutes à une demi-heure —, avec un résultat incomparablement plus profond.
Le Deep Research est utile aux deux extrêmes du savoir : quand vous « ne savez rien » (pour construire un répertoire minimum avant une réunion avec un spécialiste) et quand vous « en savez beaucoup » (pour vous actualiser rapidement sur ce que la littérature a de plus récent). Précisez les sources que le Deep Research doit prioriser : les articles en texte intégral sur PubMed, la jurisprudence d’un tribunal spécifique, les protocoles du Ministère de la Santé, etc.
Vous allez conduire une recherche approfondie sur la santé mentale et l'usage des LLM (grands modèles de langage).

Fournissez des exemples ou des cas, les risques, la prévalence mondiale et brésilienne des troubles mentaux les plus fréquents, et discutez de la manière dont l'usage des LLM peut ou non représenter une menace pour la population générale.

Présentez également la couverture médiatique du sujet et la manière dont les grandes entreprises technologiques y répondent.

En complément, recherchez et analysez les articles scientifiques liés au sujet (critères EBM avec niveau de preuve A/B, uniquement des articles en texte intégral disponibles sur PubMed/Medline) puis résumez leurs principaux résultats.
Comparatif : Deep Research vs. Deep Search
| IA / Outil | Nomenclature | Différentiel principal |
|---|---|---|
| ChatGPT (OpenAI) | Deep Research | La référence actuelle. Génère des rapports longs et structurés. Excellent pour décomposer des problèmes complexes. |
| Gemini (Google) | Deep Research / Grounding | La deuxième meilleure option parmi les outils les plus connus. |
| Perplexity | Pro Search (Deep Search) | Axé sur la vérification des faits et l'actualité récente. |
| Claude (Anthropic) | Projects / Analysis | Ne se concentre pas sur la recherche web native, mais sur l'analyse approfondie des bibliothèques de documents que vous envoyez. |
| Kimi (Moonshot) | Kimi Research | Bon produit, mais limité à 1 Deep Research par jour dans la version gratuite. |
| Grok (xAI) | Deep Search (Real-time) | Peut-être la meilleure option pour les nouvelles extrêmement récentes (breaking news). |
| GLM (Zhipu/Z.ai) | Recherche web intégrée + AutoGLM-Web | N’a pas de produit « Deep Research » propre portant ce nom ; le chat (chat.z.ai) navigue et cherche déjà sur le web pendant la réponse, et l’extension AutoGLM-Web élargit cela à une navigation autonome des pages. Considérez-le comme un intermédiaire entre une recherche simple et un Deep Research complet. |
Résumé du choix : Besoin d’un dossier technique ? ChatGPT ou Gemini. Besoin de vérifier des faits et des actualités ? Perplexity ou Grok. Besoin d’analyser 50 PDF que vous avez déjà ? Claude ou Gemini Notebook (que nous verrons ensuite).
Remarque : ZCode, de Z.ai (cité dans la grille des outils agentiques), n’est pas un outil de recherche — c’est un environnement de développement agentique pour la programmation avec les modèles GLM, équivalent de Claude Code ou de Codex. C’est pourquoi il n’apparaît pas dans ce tableau du Deep Research.
Canvas ("tableau")
Le mode Canvas vous permet de modifier et de relire le contenu en cours de construction. Prenons un exemple pratique : vous devez réviser un document que vous avez créé (un compte rendu, un article, un chapitre de livre...) et, au lieu de simplement demander à l’IA de le modifier pour vous, vous pouvez ouvrir le document dans Canvas et le modifier conjointement avec l’IA, en éditant directement ce qui vous semble devoir l’être et en demandant à l’IA d’effectuer d’autres modifications (résumer un paragraphe, développer une section...).
Attention à un changement récent : ChatGPT removeu le mode Canvas de ses modèles principaux en 2026 — l’édition de texte et de code se fait désormais directement dans la conversation même, dans des « blocs » modifiables, sans panneau séparé. Aujourd’hui, Gemini est l’outil de référence pour ce type d’espace d’édition collaborative dédié, et c’est là que l’exemple ci-dessous fonctionne le mieux.
Le Canvas peut être un outil extrêmement puissant pour l’édition de code, de pages (HTML) et même de documents. Je préfère éditer moi-même mes textes et je partagerai, dans le champ ci-dessous, le prompt que j’utilise, afin que vous puissiez le copier et l’adapter à votre réalité :
Vous réviserez le texte joint afin d'identifier d'éventuelles fautes de grammaire ou de frappe. Évaluez-le en termes de cohérence et de cohésion, sans l'éditer directement : appliquez un format barré aux passages que vous suggérez de supprimer et ajoutez, à côté, vos propositions en gras, afin que je puisse repérer ce qui doit être modifié et en juger moi-même.
Rappelons que ce type de fonction évolue vite — le Canvas de GPT lui-même a existé puis a été abandonné au cours de la vie de ce e-book. La meilleure façon de comprendre et d’apprendre les usages de l’outil, c’est de pratiquer ; alors, au travail !
Gemini Notebook (anciennement NotebookLM)
En juillet 2026, Google a rebaptisé NotebookLM en Gemini Notebook, dans le cadre d’une intégration plus étroite avec le reste de l’écosystème Gemini. C’est le même outil, avec le même propos — si vous utilisiez NotebookLM, vos notebooks restent exactement où ils étaient, et les anciens liens continuent de fonctionner. Dans ce e-book, j’utilise « Gemini Notebook » désormais, mais ne vous étonnez pas de croiser encore l’ancien nom çà et là.
C’est mon outil d’IA préféré, et je vais expliquer pourquoi. Il y a quelque temps, il est devenu célèbre pour la possibilité de générer des « résumés audio » — excellente fonctionnalité, mais ce n’est pas la raison principale pour laquelle je l’utilise autant.
Revenons à notre discussion sur les hallucinations : grâce à des ajustements du prompt et à l’ancrage (grounding) des sources, nous parvenons à réduire au maximum le taux d’hallucinations. C’est exactement ce que fait Gemini Notebook : il ne consulte — et ne répond — qu’à partir des sources que vous choisissez d’utiliser.
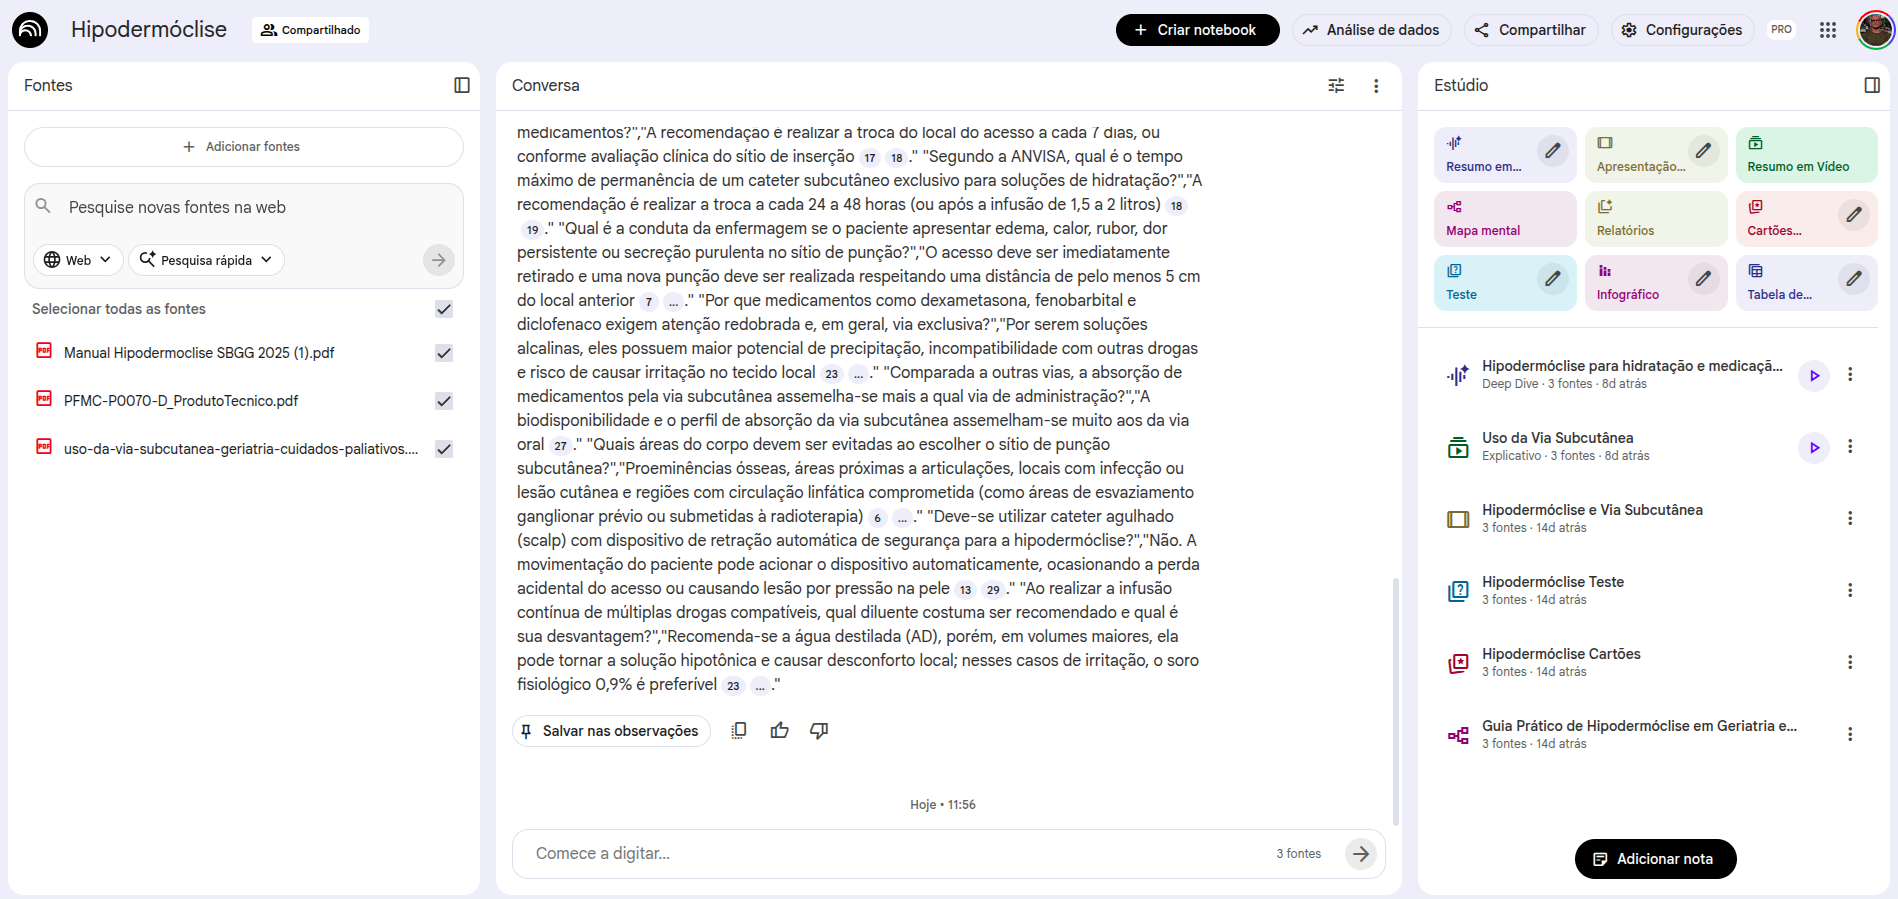
Lorsque vous créez un notebook, le premier écran sert à choisir les sources. Vous pouvez ajouter des documents, des fichiers du Drive, des Google Docs (feuilles de calcul comprises), des vidéos YouTube, des URL de sites et des fichiers audio. Tout ce matériau devient votre source, et todas les réponses extraites de vos prompts viendront exclusivement des sources que vous avez ajoutées. Si vous avez déjà entendu parler du RAG (retrieval augmented generation), c’est plus ou moins ce que fait Gemini Notebook — en réduisant au minimum possible les erreurs et les hallucinations.
Comment ajouter des sources dans Gemini Notebook
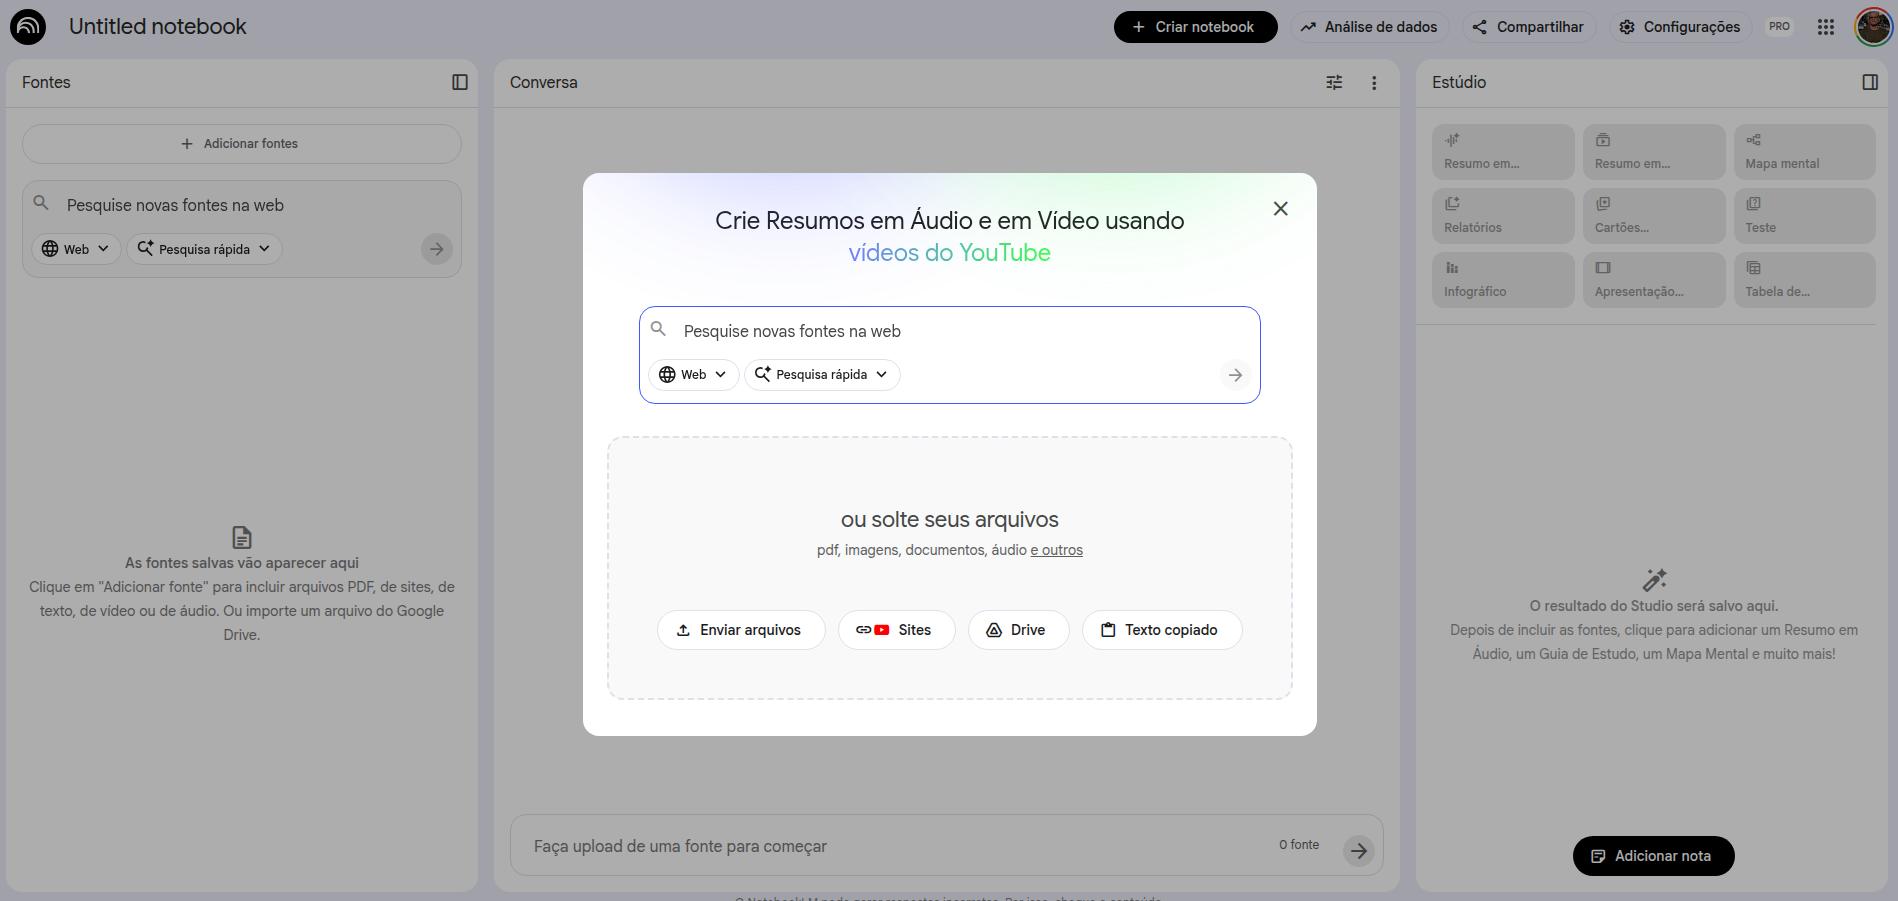
Une fois les sources ajoutées, l’interface s’organise comme suit : à gauche, les sources ajoutées (vous pouvez les retirer ou en ajouter d’autres) ; au centre, l’interface de prompt ; à droite, les ressources d’interaction que fournit Gemini Notebook.
Ressources disponibles dans Gemini Notebook
Le panneau de ressources comprend :
- Résumé audio (podcast avec deux animateurs discutant de vos sources)
- Guide d'étude (questions à choix multiples, réponses courtes et questions ouvertes)
- FAQ (questions fréquentes sur le contenu)
- Résumé et chronologie
- Document de briefing (résumé exécutif)
- Carte mentale
- Infographies
- Flashcards et quiz
- Analyse de données avec code (fonctionnalité la plus récente : un environnement sécurisé dans le cloud qui écrit et exécute du code pour croiser vos sources, générant à partir d’elles des graphiques, des feuilles de calcul et des rapports)
Presque toutes les ressources affichent une icône de « crayon » — ce qui signifie que vous pouvez modifier les instructions par défaut de cette ressource en insérant un prompt personnalisé.
Édition des ressources — exemple pour l'audio
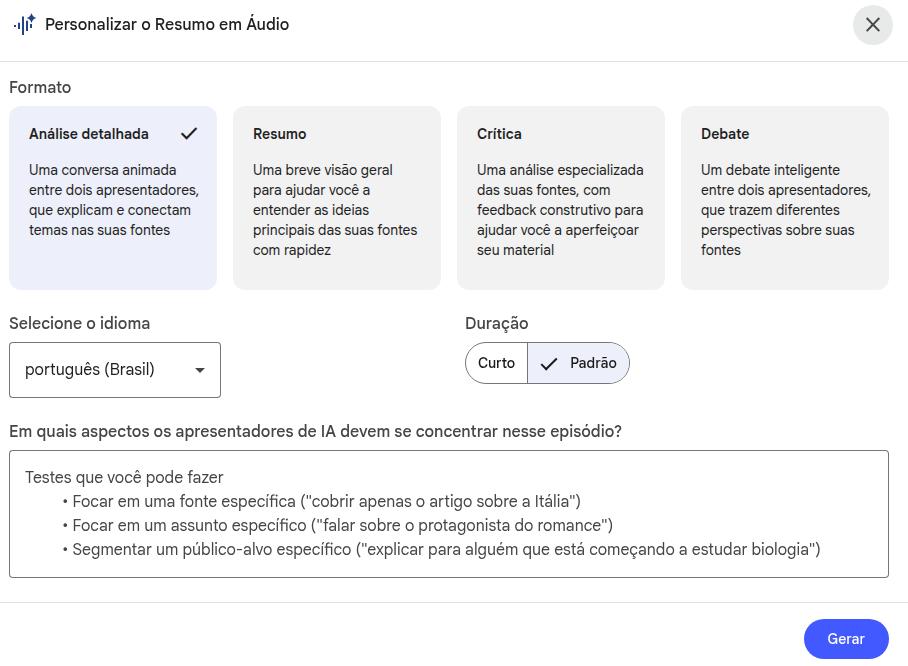
Vous produirez un fichier audio aussi détaillé et étendu que possible, abordant les détails méthodologiques avec rigueur et précision : décrivez en profondeur comment la structure du produit développé a été mise en place, les détails du prompt de débat (s'il s'agissait d'une stratégie d'IA agentique avec plusieurs personas ou si, en réalité, différents agents ont été utilisés). Enfin, attardez-vous sur les résultats en les décrivant en détail et en expliquant leurs implications pour la santé.Fenêtre de contexte étendue
Gemini Notebook offre une fenêtre de contexte d’un million de tokens, permettant l’interaction avec de multiples documents étendus simultanément — des livres entiers, des articles scientifiques, des transcriptions de réunions. Contrairement aux IA classiques, il a été conçu spécifiquement pour « consulter professionnellement » plusieurs fichiers : ses sources restent séparées de la fenêtre de conversation, mais totalement accessibles au modèle. Cela vous permet de dialoguer longuement avec les documents, sans que leur taille perturbe la mémoire de la conversation.
Chaque réponse s’accompagne de la citation précise de l’extrait original de votre document, ce qui facilite la vérification et augmente considérablement la fiabilité pour un usage professionnel.
Écosystème Google : intégration et mise à jour dynamique
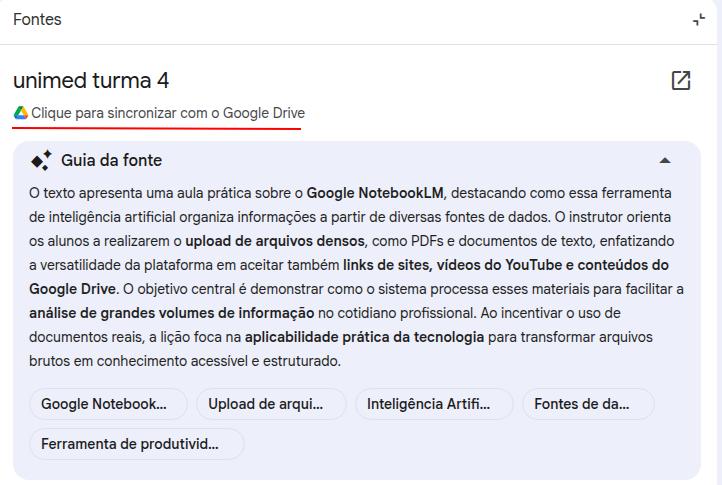
Gemini Notebook s’intègre à l’écosystème Google et permet d’utiliser des dossiers et documents du Google Drive comme sources. Le point le plus utile : quand vous connectez un Google Docs comme source, Gemini Notebook conserve le lien avec le fichier d’origine — que vous pouvez mettre à jour quand vous voulez. Lorsqu’il détecte que la dernière version a changé, Gemini Notebook propose un bouton pour actualiser la source.
Transcription audio et vidéo
Gemini Notebook permet de transcrire intégralement des audios et des vidéos : il suffit de les ajouter comme sources et de demander, via un prompt, la transcription du matériau. Vous pouvez inclure des instructions de mise en évidence : imaginez que vous avez enregistré une réunion qui devra être transformée en compte rendu, ou un cours où le professeur met fréquemment en évidence des informations importantes. Exemples :
Transcrivez intégralement le contenu de la source, en identifiant, lorsque c'est possible, les différents interlocuteurs.

Ensuite, rédigez un compte rendu formel de la réunion en incluant les éléments suivants : date, participants identifiés, ordre du jour discuté, décisions prises et actions de suivi avec leur responsable.
Gemini Notebook gratuit ou payant
Il existe des différences entre les versions gratuite et payante : nombre de notebooks créables, nombre de sources par notebook, nombre de ressources créées/jour et, subjectivement, vitesse de génération de certaines ressources (impression personnelle). Ma suggestion : commencez avec la version gratuite et, seulement une fois l’outil bien maîtrisé, passez à la version payante (si nécessaire). Le niveau payant n’est pas vendu séparément : il est inclus dans les abonnements Google AI Plus, Pro et Ultra.
- Plus de notebooks et plus de sources par notebook (limites supérieures à celles de la version gratuite)
- Plus de générations de résumés audio par jour
- Audios plus longs et plus détaillés
- Intégration plus poussée avec Google Workspace
- Fonctions de partage des notebooks avec des équipes
- Support prioritaire et accès anticipé aux nouvelles fonctionnalités
Attention — changement de limites en septembre 2026 : au 2 septembre 2026, Google a modifié les limites de Gemini Notebook : au lieu d’un nombre fixe de questions/ressources par jour, la limite repose désormais sur la complexité et de la longueur de chaque tâche (le volume de texte chargé, la taille de l’historique de conversation et les ressources activées). En pratique : quelques tâches très complexes peuvent épuiser votre limite plus vite que de nombreuses tâches simples — l’application vous avertit quand vous approchez du plafond, et les limites se renouvellent toutes les quelques heures. La règle vaut pour les utilisateurs gratuits comme payants, mais les comptes payants conservent une marge bien plus généreuse. Des limitations différentes subsisteront, pour les comptes gratuits et payants, quant au nombre de notebooks par utilisateur et de sources par notebook. Plus d’informations sur Notebook updates
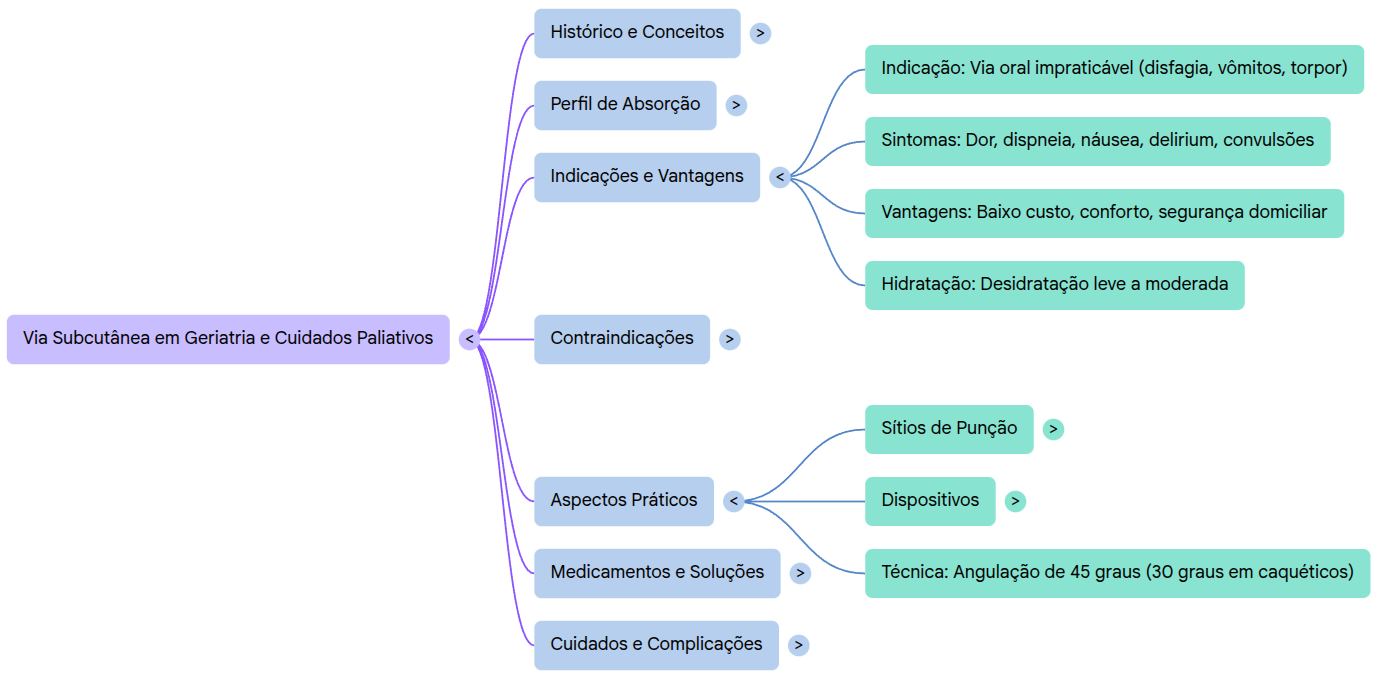
Gemini Notebook est particulièrement utile dans les contextes académiques ! Je l’utilise beaucoup pour interagir avec des textes académiques (des articles en PDF, par exemple — et maintenant des fichiers EPUB aussi)
- Revue de littérature : ajoutez les articles sélectionnés et utilisez le prompt pour synthétiser les principaux résultats, comparer les méthodologies ou identifier les lacunes de connaissance.
- Étude des recommandations : chargez les recommandations les plus récentes d’une spécialité et posez-leur directement des questions cliniques
- Préparation de présentations : utilisez les fonctions Guide d’étude et FAQ pour générer des questions sur le contenu de cours ou de conférences
- Journal d’apprentissage : gardez un Google Docs avec des notes quotidiennes et connectez-le à Gemini Notebook ; en fin de semaine, générez un résumé ou un quiz sur ce que vous avez appris.
- Astuce « pro » : utilisez Gemini Notebook comme tuteur personnel ! Étudiez un article et expliquez-le-lui, en lui demandant de corriger et de compléter les points critiques que vous aurez mal compris ou laissés de côté.
OpenEvidence
Qu'est-ce qu'OpenEvidence ?
OpenEvidence est une plateforme d’aide à la décision clinique fondée sur l’IA, développée spécifiquement pour les médecins et professionnels de santé. Contrairement aux modèles d’usage général (comme ChatGPT et Gemini), OpenEvidence a été entraîné et optimisé pour les requêtes médicales, avec accès à une littérature médicale spécifique et curée par son équipe éditoriale.
La plateforme a des accords de contenu avec plusieurs organisations de référence comme NEJM (New England Journal of Medicine), JAMA, NCCN (National Comprehensive Cancer Network), Cochrane, Wiley, ACC (American College of Cardiology), ADA (American Diabetes Association) et d’autres sociétés médicales.
Comment cela fonctionne-t-il ?
Le fonctionnement est simple et très semblable à la logique derrière les autres LLMs :
- Vous posez une question clinique en anglais ou en portugais
- L'outil interroge ses propres bases de littérature médicale
- Il renvoie une réponse avec citations et liens vers les sources originales
- Vous pouvez poser des questions de suivi dans la même session pour approfondir
Access it at: www.openevidence.com
Bonnes pratiques de prompt pour OpenEvidence
Comme pour tout outil d’IA, la qualité de la réponse dépend de la qualité de la question. Pour OpenEvidence, les pratiques ci-dessous font une différence significative :
1. Inclure le contexte clinique pertinent du patient
Au lieu de demander génériquement « quel est le traitement de l’hypertension ? », fournissez du contexte :
68-year-old male with a 10-year history of hypertension, type 2 diabetes, and an eGFR of 45 mL/min/1.73m². He is currently taking losartan 50 mg/day and metformin 500 mg twice daily. Current blood pressure: 155/95 mmHg. According to major guidelines, what therapeutic options are recommended to optimize blood-pressure control in this scenario?2. Préciser le type d'information souhaité
What are the current indications for anticoagulation in non-valvular atrial fibrillation? Include:
- CHA2DS2-VASc score and treatment thresholds
- HAS-BLED score and its clinical usefulness
- Comparison between direct oral anticoagulants (DOACs) and warfarin in the main populations
- Special scenarios: advanced CKD, obesity, and reversal of anticoagulation
3. Demander le niveau de preuve et la qualité des études
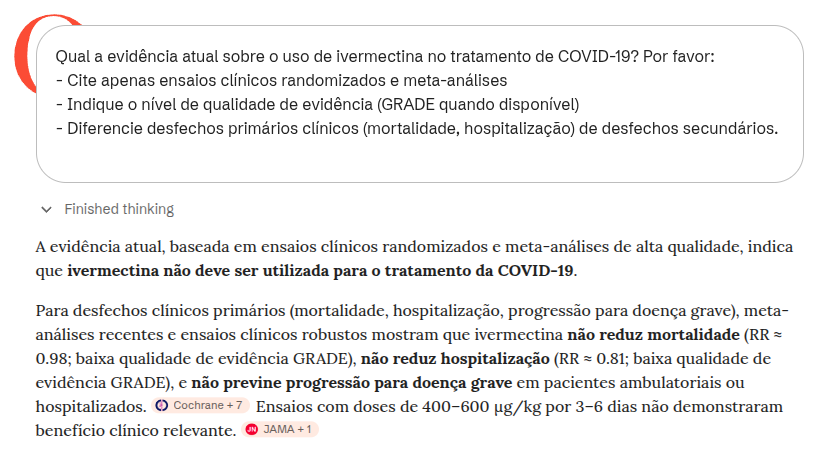
What is the current evidence on the use of ivermectin for treating COVID-19? Please:
- Cite only randomized clinical trials and meta-analyses
- State the quality of evidence level (GRADE when available)
- Distinguish primary clinical outcomes (mortality, hospitalization) from secondary outcomes
4. Comparer directement des options thérapeutiques
Compare the efficacy and safety of SGLT2 inhibitors versus GLP-1 receptor agonists in patients with type 2 diabetes and established cardiovascular disease, based on randomized clinical trials with hard cardiovascular outcomes (MACE, cardiovascular mortality, hospitalization for heart failure).5. Utiliser les questions de suivi pour approfondir
OpenEvidence permet des questions de suivi dans la même session. Par exemple, après avoir obtenu une réponse sur le traitement initial, vous pouvez demander :
What if this patient also has heart failure with reduced ejection fraction (HFrEF)? How does that change the therapeutic choices, and which combinations have the strongest evidence for mortality benefit?Précautions fondamentales dans l'usage d'OpenEvidence
OpenEvidence est un outil puissant, mais son usage inadéquat peut conduire à des erreurs cliniques. Trois précautions sont particulièrement importantes :
1. Le prompt oriente la réponse et peut la biaiser
La manière dont vous construisez le prompt influence directement ce que l’outil présente. Si vous demandez « quelles sont les preuves en faveur de l’usage de X ? », l’outil tendra à présenter des preuves favorables — même s’il existe des preuves contraires pertinentes et de meilleure qualité méthodologique. Des questions plus neutres (« quelles sont les preuves concernant l’usage de X ? ») génèrent des réponses plus équilibrées. Formuler ses questions de façon neutre et vérifier activement s’il existe des preuves contraires est une bonne pratique.
2. L'outil peut confondre critères de jugement primaires et secondaires
Une erreur fréquente — chez les utilisateurs comme dans l’outil — est de traiter les critères de substitution (biologiques, microbiologiques, radiologiques) comme équivalents aux critères cliniques durs. Par exemple : un antibiotique peut « éradiquer » une bactérie (critère microbiologique) sans améliorer la survie du patient (critère clinique). Un médicament peut réduire l’hémoglobine glyquée (critère biologique) sans réduire la mortalité cardiovasculaire. Questionnez toujours : l’étude citée mesure-t-elle le critère qui compte pour mon patient ?
3. Savoir qu’une preuve existe et savoir l’interpréter sont des choses très différentes
OpenEvidence peut citer un essai clinique randomisé sans contextualiser adéquatement sa qualité méthodologique, la taille réelle de son effet, son applicabilité à votre patient ou son risque de biais. Des concepts comme le NNT (nombre de patients à traiter), les intervalles de confiance, l’hétérogénéité des méta-analyses et la qualité GRADE sont essentiels pour interpréter correctement les preuves fournies. L’outil appuie la décision clinique ; il ne la remplace pas.
Précaution supplémentaire : l’outil ne remplace pas votre jugement clinique individualisé
Les réponses d’OpenEvidence reposent sur des populations d’études qui peuvent ne pas refléter les caractéristiques spécifiques de votre patient (comorbidités, interactions médicamenteuses, valeurs et préférences). Ne considérez aucun outil d’IA comme un « oracle suprême » — pas même OpenEvidence.
Précautions d’usage des outils d’IA
Bien que les IA soient des outils puissants, leur usage exige responsabilité et connaissance de leurs limites, en particulier dans des domaines critiques comme la santé. Ci-dessous, nous soulignons quatre points d’attention fondamentaux.
1) Hallucination (Hallucination)
Le terme « hallucination » en IA désigne la génération d’informations qui semblent correctes et sont présentées avec une grande confiance, mais qui sont fausses ou inventées. Cela se produit parce que le modèle prédit le mot suivant le plus probable, pas nécessairement la vérité. En santé, cela peut signifier l’invention de conduites, de doses de médicaments ou de citations d’articles qui n’existent pas. Vérifiez toujours les sources.
2) Risque de biais (Bias)
Les modèles d’IA sont entraînés sur de vastes ensembles de données issus d’internet, qui contiennent les préjugés et biais de la société. Cela peut produire des réponses qui perpétuent des stéréotypes de genre, de race ou socioéconomiques, ou qui montrent un biais dans les diagnostics médicaux (par exemple, en sous-diagnostiquant certaines conditions dans des groupes démographiques spécifiques). Soyez attentif à ces distorsions.
3) Le paradigme de la « boîte noire » (Black Box)
Nous ne savons pas exactement como ou por que une IA est parvenue à une conclusion donnée. Nous ne savons pas quels matériaux ont été utilisés dans l’entraînement ni quelles sources spécifiques ont fondé une réponse particulière. En outre, les processus internes des réseaux neuronaux sont complexes et peu transparents. C’est critique en pratique clinique, où l’explicabilité est fondamentale pour la sécurité et la confiance dans la prise de décision.
4) Ce que dit la réglementation brésilienne
Depuis le 26 août 2026, l’usage de l’intelligence artificielle dans la pratique médicale au Brésil est réglementé par la la Résolution CFM n° 2.454/2026. Vous n’avez pas besoin de mémoriser les détails, mais il vaut la peine de connaître les principes centraux, car ils confirment — désormais aussi en tant que norme — exactement ce que nous n’avions cessé de souligner dans ce e-book :
- L'IA est une aide à la décision ; la décision clinique finale doit toujours être humaine.
- L'IA ne peut pas communiquer un diagnostic, un pronostic ou une conduite directement au patient — cela reste le rôle du médecin.
- L'utilisation de l'IA en soins doit être documentée dans le dossier médical (outil utilisé, finalité et révision humaine de la suggestion).
- Le médecin demeure entièrement responsable des actes pratiqués avec le soutien de l'IA — l'outil ne partage ni ne transfère cette responsabilité.
Comme toute norme récente, il peut exister des mises à jour ou des réglementations complémentaires après la publication de ce matériau — il vaut la peine de consulter le texte en vigueur directement sur le site du CFM (cfm.org.br) avant de fonder sur lui une quelconque décision de conformité.
Précaution supplémentaire : la nécessité d'une relecture humaine
N’utilisez jamais le résultat d’une IA directement pour la prise de décision clinique sans révision rigoureuse. L’outil peut servir de soutien, mais la responsabilité et le jugement final sont toujours humains (human-in-the-loop) — et, au Brésil, cela a cessé d’être une simple bonne pratique pour devenir une exigence réglementaire.
Prompts avancés pour consultation
Cette section fonctionne comme un catalogue de consultation : des techniques de prompting plus sophistiquées, chacune avec un exemple générique (prêt à éditer) et, dans la plupart des cas, un second exemple déjà appliqué à un contexte — clinique, juridique ou administratif — pour que vous voyiez le modèle à l’œuvre. Inutile de mémoriser les noms anglais ; revenez ici chaque fois que vous aurez besoin de copier et d’adapter l’un de ces canevas à votre tâche du moment.
Prompt pour décomposer des tâches complexes (pour la productivité)
Exemple[TASK DECOMPOSITION - REAL EXAMPLE]
My main task is: Prepare a 2025 departmental spending-analysis report for presentation to the executive board.
Please break this down into sequential subtasks, numbered from 1 to N.
For EACH subtask, provide:
- Subtask number and title
- Description of what needs to be done
- Success criterion
- Any prior dependency
- Estimated time
Additional context:
- We have data from three sources: SAP, internal spreadsheets, and department receipts
- The presentation is in 2 weeks
- Audience: 8 non-technical executives
- Expected format: 15-20 slides with the main chartsExemple modifiable
[TASK DECOMPOSITION]

My main task is: [DESCRIBE THE OVERALL TASK]

Please break it into sequential subtasks, numbered from 1 to N.

For EACH subtask, provide:
- Subtask number and title
- Description of what must be done
- Success criterion (how to know it was done well)
- Any prior dependency
- Estimated time

Then present a recommended execution timeline.
Chaîne de Pensée (Chain of Thought)
Exemple modifiable:
[Chain of Thought - EDITABLE]
You are a [SPECIALIST IN WHAT?].
Analyze: [DESCRIBE THE CASE / PROBLEM]

Think step by step:
1. [WHAT IS THE FIRST LOGICAL STEP?]
2. [WHAT IS THE SECOND STEP?]
3. [WHAT IS THE THIRD STEP?]

Respond by detailing each step of your reasoning.
Exemple complet:
[Chain of Thought - FULL]
You are a project manager. Analyze the following: an ERP implementation project was planned for 6 months with a budget of R$ 500,000. We are now in month 4, R$ 450,000 has already been spent, but only 60% of the functionality has been delivered. The client is dissatisfied.

Think step by step:
1. Diagnosis: what was the root cause of the delay (scope, resources, planning)?
2. Impact analysis: how much extra time and cost will be required?
3. Strategy: what options exist (extension, scope reduction, larger team)?

Respond by detailing each stage.
Arbre de Pensée (Tree of Thought)
Exemple modifiable:
[Tree of Thought - MODIFIABLE]
Analysez : [DÉCRIVEZ UN SCÉNARIO COMPLEXE AVEC PLUSIEURS OPTIONS]

Élaborez un arbre de pensées simulant plusieurs scénarios :

Scénario 1 : [PREMIÈRE OPTION]
- Sous-conséquence 1a : [...]
- Sous-conséquence 1b : [...]
- Issue probable : [...]

Scénario 2 : [DEUXIÈME OPTION]
- Sous-conséquence 2a : [...]
- Sous-conséquence 2b : [...]
- Issue probable : [...]

Scénario 3 : [TROISIÈME OPTION]
- Sous-conséquence 3a : [...]
- Sous-conséquence 3b : [...]
- Issue probable : [...]

Synthèse : Quel scénario présente la plus forte probabilité de succès ?
Exemple complet:
[Tree of Thought - COMPLET]
Une entreprise doit décider d’une expansion internationale. Analysez les trois scénarios principaux :

Scénario 1 : Marché asiatique (risque élevé, rendement élevé)
- Investissement initial : 10 M$
- Barrières réglementaires : élevées
- Potentiel de marché : 500 M de personnes
- Issue probable : Retour sur 4-5 ans si l’entrée est réussie

Scénario 2 : Marché d’Amérique latine (risque moyen, rendement moyen)
- Investissement initial : 5 M$
- Barrières réglementaires : moyennes
- Potentiel de marché : 150 M de personnes
- Issue probable : Retour sur 2-3 ans

Scénario 3 : Marché européen (risque faible, rendement faible)
- Investissement initial : 3 M$
- Barrières réglementaires : élevées
- Potentiel de marché : 100 M de personnes
- Issue probable : Retour stable sur 1-2 ans

Synthèse : L’Amérique latine offre le meilleur équilibre risque-rendement pour une expansion à court terme.
Chaîne d’Apprentissage (Chain of Learning)
Exemple modifiable:
[Chain of Learning - Exemple modifiable]
Vous agirez comme simulateur interactif pour mon entraînement en [QUEL DOMAINE ?].

[Votre rôle]
1. Créez un scénario ou un problème initial sur [SUJET SPÉCIFIQUE]
2. Ne révélez pas immédiatement la solution
3. Fournissez des informations neutres au fur et à mesure de ma progression
4. Ajustez la difficulté en fonction de ma performance
5. Révisez mon raisonnement et signalez les lacunes

[Format d'interaction]
- Je présente mon analyse ou ma solution
- Vous fournissez un retour constructif
- Nous itérons jusqu'à l'acquisition d'une véritable maîtrise

Je suis prêt à commencer. Quel est le domaine et le sujet ?
Exemple complet:
[Chain of Learning - Exemple complet]
Vous agirez comme simulateur interactif pour mon entraînement en épidémiologie clinique.

[Votre rôle comme enseignant-simulateur]
1. Créez un scénario réaliste d'épidémie (par exemple : "Nous avons détecté 15 cas de gastro-entérite dans une crèche en 3 jours")
2. Ne révélez pas immédiatement l'étiologie la plus probable
3. Fournissez les données au fur et à mesure que je les demande (symptômes, incubation, expositions, laboratoire)
4. Augmentez la complexité à mesure que je démontre ma compréhension (par exemple : facteurs de confusion)
5. Révisez mon raisonnement épidémiologique (mon hypothèse initiale était-elle pertinente ?)

[Ma démarche]
- Je formulerai des hypothèses sur la source et le mode de transmission
- Je demanderai des données spécifiques pour tester ces hypothèses
- Vous me donnerez un retour sur la pertinence de l'investigation

Je suis prêt. Présentez un scénario d'épidémie.
Chaîne de Vérification (Chain of Verification)
Technique qui réduit les hallucinations en demandant à l'IA de générer des questions de vérification et de contrôler ses propres prémisses avant de fournir la réponse finale.
[Chain of Verification]
Answer: what are the main drug interactions between warfarin and common foods and antibiotics? After answering, follow this verification protocol: 1. Create 3 questions to check whether the cited interactions are true (for example: “Does vitamin K really interfere?”). 2. Answer those questions independently. 3. Provide a revised and corrected final answer based on those checks.
Même logique appliquée à un contexte juridique :
[Chain of Verification]
List 3 recent decisions from the Brazilian Superior Court of Justice (STJ) on hospital civil liability. Follow the CoVe protocol: 1. Generate questions to confirm case number and year. 2. Answer whether the cases exist and actually concern the topic. 3. Deliver only the confirmed cases.
Chaîne de Débat (Chain of Debate)
Simule un débat entre plusieurs perspectives (personas) pour explorer un thème complexe et parvenir à une synthèse plus équilibrée.
[Chain of Debate] Vous agirez comme deux médecins spécialistes débattant en interne. Contexte : patient âgé, fragile, avec plusieurs comorbidités et un diagnostic récent de cancer avancé. Tâche : simulez un débat interne structuré : le Spécialiste A défend un traitement agressif et le Spécialiste B défend des soins palliatifs précoces. Chacun doit présenter ses arguments, réfuter ceux de l'autre et reconnaître les limites. Concluez par une synthèse équilibrée.La technique fonctionne tout aussi bien hors médecine — voyez un exemple juridique :
[Chain of Debate]
Simulate a discussion between a defense attorney, a prosecutor and a judge about the admissibility of WhatsApp evidence obtained without authorization in a corruption case. Debate “Fruit of the Poisonous Tree” versus “Public Interest.”
Autocohérence (Self-Consistency)
Génère plusieurs raisonnements indépendants pour le même problème et vérifie la cohérence entre eux pour formuler une conclusion plus robuste (la « majorité l’emporte »).
[Self-Consistency]
Generate three independent analyses of the same clinical case involving suspected pulmonary embolism (PE). Produce three separate diagnostic reasoning paths. Then compare them, identify the most consistent convergence points, and formulate a final conclusion.
Autre contexte, même principe :
[Self-Consistency]
Generate three independent legal analyses of the same contractual case. Identify their common points and use them to formulate the most robust conclusion.
Autocritique (Reflexion)
Obligatoire pour les tâches critiques : demande à l’IA de critiquer sa propre réponse initiale et de l’affiner sur la base de cette autocritique.
[Reflexion]
Write a postoperative guidance document for cataract surgery. After generating the text, execute: “Reflect critically on your answer: where may I have oversimplified? Which assumptions may be wrong? What additional information would change my conclusion?” After that reflection, refine your original answer.
Hors médecine, le même principe vaut pour une consultation juridique :
[Reflexion]
Reflect critically on the legal opinion you have just produced. Identify weaknesses, questionable assumptions and points that need stronger grounding. Revise the opinion after that analysis.
Enchaînement de Prompts (Prompt Chaining)
Décompose une tâche complexe en une séquence de prompts où la sortie de l’un sert d’entrée au suivant.
[Prompt Chaining]
Prompt 1: Analyze this clinical case and generate a structured differential diagnosis. Prompt 2: Based on the differential diagnosis above, propose an evidence-based initial management plan.
En appliquant la même logique d’enchaînement à un cas juridique :
[Prompt Chaining]
Prompt 1: Summarize the main legal risks in the presented case. Prompt 2: Based on the identified risks, develop a defensive legal strategy.
Connaissance Générée (Generated Knowledge)
Demande à l'IA d'utiliser une logique de programmation ou du pseudo-code pour structurer des raisonnements logiques ou mathématiques avec davantage de précision.
[Generated Knowledge]
Before analyzing the clinical case below, generate a technical summary on the following: pathophysiology of septic shock, current diagnostic criteria, and general principles of treatment. Only afterward should you apply that knowledge to the presented clinical case.
Et dans un contexte contractuel :
[Generated Knowledge]
Before analyzing the case, generate a technical summary on the following: principles of contractual good faith and legal grounds for rescission. Then apply that knowledge to the concrete case.
Du plus simple au plus complexe (Least-to-Most)
Stratégie pédagogique et de résolution de problème qui demande d'expliquer le concept du niveau le plus simple au plus avancé, ou de résoudre d'abord les sous-problèmes simples avant d'aborder le problème complexe.
[Least-to-Most]
First explain, in simple language, what heart failure is. Then: 1. Explain the pathophysiological mechanisms. 2. Differentiate HF with preserved versus reduced ejection fraction. 3. Relate that distinction to therapeutic choice.
En appliquant la même logique à une due diligence :
[Least-to-Most]
To conduct due diligence on a startup, first identify the 4 critical risk areas. Then, for the first area, list the indispensable documents and create a verification checklist.
Stimulus Directionnel (Directional Stimulus)
Fournit des indices ou des signaux directionnels spécifiques pour orienter le raisonnement du modèle vers une priorité souhaitée (par exemple, la sécurité).
[Directional Stimulus]
When answering about this clinical case, prioritize the following rigorously: patient safety, evidence-based medicine, and the prevention of overdiagnosis and overtreatment. [Describe the clinical case here].
Et dans un contexte de contentieux :
[Directional Stimulus]
When answering about this dispute, prioritize the following: minimization of legal risk, conservative interpretation of the law, and protection of the client’s assets. [Describe the case.]
Raisonnement Assisté par Code (Program-Aided Language)
Demande à l'IA d'utiliser une logique de programmation ou du pseudo-code pour structurer des raisonnements logiques ou mathématiques avec davantage de précision.
[Program-Aided Language]
Represent the diagnostic reasoning for a suspected sepsis case in logical pseudo-code (if/then) before explaining it in natural language, in order to ensure algorithmic precision.
Autre usage typique, cette fois pour un calcul financier :
[Program-Aided Language]
Calculate the value of a R$ 50,000 debt due on 10/01/2023, with 1% interest and IPCA inflation of 4.5%. Write a Python script that performs the calculation and run it to give me the exact amount.
ReAct (Raisonnement + Action)
Alterne pensée (raisonnement) et action (recherche d'information ou usage d'un outil) dans une boucle continue pour résoudre des problèmes dynamiques.
[ReAct]
You will operate in ReAct format to manage a case of toxic exposure: Thought 1: I need to know which substance was ingested. Action 1: Ask the user. Thought 2: Based on the response, I should check the antidote. Action 2: Provide the dose. Continue the cycle until stabilization.
Et dans un contexte juridique :
[ReAct]
Alternate between legal reasoning and action: Thought: What does this notice mean? Action: Which document should be reviewed? Thought: What are the implications? Action: What response is recommended? Continue until a final strategy is reached.
Que sont les harness ?
Si vous avez déjà remarqué que « le même ChatGPT » se comporte de manières très différentes selon onde vous l’utilisez ? La logique est à peu près la suivante : GPT est le modèle et il est placé dans plusieurs contextes différents : via la page internet, vous accédez au chatGPT; sur l’ordinateur, pour générer du code, vous utilisez codex — le modèle est le même, mais les outils auxquels il a accès et les instructions de base qui disent ce qu’il peut faire ou non sont différentes. Cet environnement autour du modèle est ce que nous appelons le harness.
Le mot vient du harnais (et de la ceinture de sécurité)
Harness, en anglais, désigne le harnais d’un cheval, le harnais de poitrail d’un chien, le baudrier d’escalade (et d’autres exemples, sans préjugé). Cette structure portée autour de la personne définit le contexte de son travail, sa sécurité, avec quels outils elle va travailler... La figure est autoexplicative
En intelligence artificielle, le harness est exactement cela : la couche logicielle qui enveloppe le modèle et lui donne des outils, de la mémoire, des permissions, de la validation et la capacité d’agir. C’est l’infrastructure qui transforme « un prédicteur de texte » (le modèle) en « un assistant qui fait différentes choses » (selon le harness).
Le modèle seul fait très peu
Rappelons ce que nous avons vu dans la section Basic mechanics: un modèle de langage (LLM), isolé, ne fait qu'une seule chose — il reçoit un texte et renvoie la continuation la plus probable, token par token. Seul, le modèle ne navigue pas sur internet, ne exécute pas de code, ne ouvre pas vos fichiers, ne se souvient pas de la conversation d'hier et ne réalise aucune action dans le monde. Il ne fait que générer du texte.
Tout ce qui semble être « l’IA en train de faire » — rechercher, lire un PDF, exécuter un calcul, générer une feuille de calcul, citer la source exacte, se souvenir de vos préférences — c’est le harness travaillant autour du modèle.
Comment fonctionne le harness, en pratique
Quand vous soumettez une tâche, le harness exécute à peu près ce cycle :
- Il reçoit la tâche et assemble le contexte (réunit votre demande, les instructions fixes, la mémoire pertinente et, le cas échéant, des extraits de documents qu’il est allé chercher pour vous).
- Il l’envoie au modèle et lit la réponse.
- Si le modèle « demande » un outil (chercher sur le web, exécuter du code, lire un fichier, interroger une API), c’est le harness qui exécute réellement cette action et renvoie le résultat au modèle.
- Répète le cycle autant de fois que nécessaire — raisonner, agir, observer le résultat, raisonner à nouveau — jusqu’à ce que la tâche soit prête.
- Applique les garde-fous (guardrails) : ce qui est permis, ce qui exige votre confirmation, ce qui doit être validé.
- Livre le résultat — souvent avec un journal des étapes et des sources (observabilité).
L’analogie du moteur et du véhicule
C’est la même logique que celle des vélos et des voitures utilisée dans la section Modèles d’IA, mais un étage au-dessus. Référence de vieux : avec un moteur de Coccinelle, vous pouvez faire aussi bien Herbie qu’un ultraléger. Le modèle est le moteur et la carrosserie — ce qui est autour — est le harness. Dans cet exemple bizarre, il est évident que le harness donne au modèle des fonctions et des caractéristiques très différentes !
C’est pourquoi « quel est le meilleur modèle ? » est une question incomplète. En pratique, vous n’utilisez presque jamais un modèle pur : vous utilisez un modèle + harness. Quand vous comparez ChatGPT avec Gemini Notebook, ou Claude sur le site avec Claude dans un éditeur de code, une bonne partie de la différence que vous ressentez vient du harness, pas du modèle.
De l’outil à l’agent
Quand le harness donne au modèle l’autonomie de planifier, agir en cycles et décider de ses propres étapes — et, parfois, faire appel à des « sous-agents » spécialisés (un pour le code, un pour les images, un pour la recherche) —, c’est de cela que les gens parlent quand ils disent agente de IA ou IA agentique. Un agent, en termes simples, est modèle + harness avec liberté d’agir.
Exemples de harnesses que vous avez probablement déjà utilisés
| Outil | Ce que le harness ajoute au modèle |
|---|---|
| Application courante (ChatGPT, Gemini, Claude) | Harness « léger » : historique de conversation, mémoire des préférences, quelques utilitaires (recherche rapide, téléversement de fichier, exécution ponctuelle de code). |
| Deep Research | Harness « lourd » de recherche : crée un plan, effectue des dizaines de recherches, croise des sources contradictoires et synthétise un rapport — le tout en cycles. |
| Gemini Notebook | harness de grounding (RAG) : oblige le modèle à répondre somente à partir des sources que vous avez ajoutées, avec citation de l’extrait d’origine. La réduction des hallucinations vient du harness, pas du modèle. |
| Environnements de programmation agentique (Claude Code, Codex, ZCode) | Harness avec accès au terminal et aux fichiers du projet : modifie le code, lance les tests, lit l’erreur, corrige et répète jusqu’à ce que cela passe. |
| IA intégrée dans un système clinique | Harness institutionnel : se connecte au dossier médical, restreint ce qui peut être fait, enregistre chaque usage et maintient le médecin comme décideur (human-in-the-loop). |
En résumé : le modèle est ce qui pense ; le harness est ce qui permet de penser avec des outils, d’agir avec des limites et de rendre des comptes sur ce qui a été fait. Sans harness, le modèle n’opère pas dans le monde réel — et c’est le harness que, en pratique, vous engagez, configurez et supervisez.
Contacts
IA e Medicina